





מבוא לנאיב בייס
שיעור 12 מתוך 19 בקורס מבוא ללמידת מכונה של Coddy.
Naive Bayes הוא אלגוריתם פשוט אך רב עוצמה המשמש למשימות סיווג בלמידת מכונה.
אלגוריתם Naive Bayes מבוסס על משפט בייס, שמלמד אותנו איך לחשב את ההסתברות של אירוע (כמו הודעת דוא״ל שהיא ספאם) על סמך ידע קודם על תנאים שעשויים להיות קשורים לאירוע. החלק ה״נאיבי״ נובע מההנחה שכל התכונות (כמו המילים בהודעת הדוא״ל) בלתי תלויות זו בזו, דבר שמפשט את החישובים. פירוש הדבר שהתרחשות של דבר אחד אינה משנה את הסיכוי שדבר אחר יתרחש.
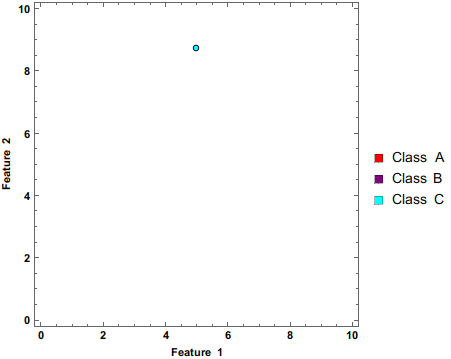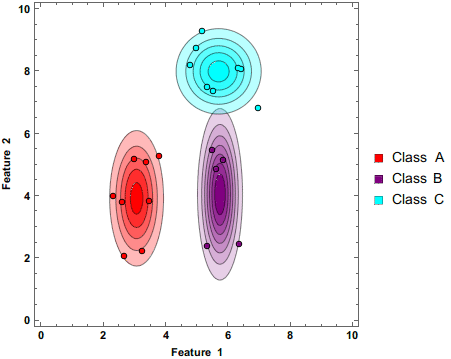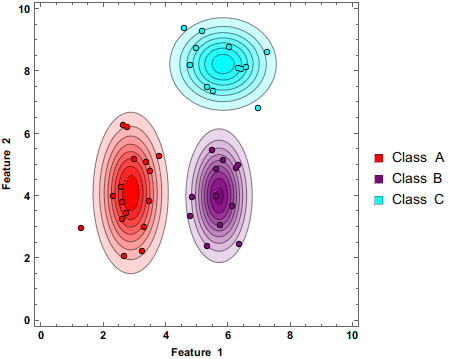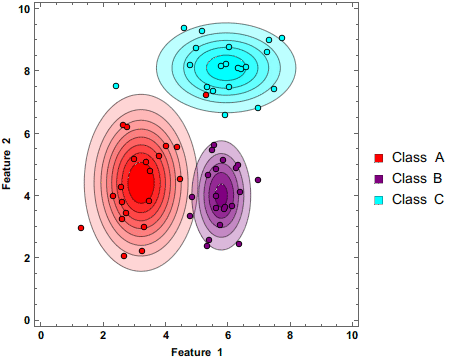
מקור: Wikipedia, מסווג Naive Bayes מעדכן את ההערכה שלו ככל שמוזנים אליו נתונים נוספים.
כך זה עובד:
- ספירת מופעים: ראשית, סופרים כמה פעמים כל נקודת נתונים מופיעה במחלקות שונות. בזיהוי הודעות דואר זבל נספור כמה פעמים כל מילה הופיעה בהודעות ספאם או בהודעות שאינן ספאם; באבחון רפואי, ייתכן שנספור כמה פעמים (או כמה זמן) מופיע כל תסמין.
- חישוב הסתברויות: עבור נקודת נתונים חדשה, מחשבים את ההסתברות שהיא שייכת לכל מחלקה (מה ההסתברות שהודעת דוא״ל חדשה היא ספאם ומה ההסתברות שהיא אינה ספאם)
- החלטה: לבסוף, האלגוריתם משלב את כל ההסתברויות האלה באמצעות משפט בייס ומחליט אם סביר יותר שהודעת הדוא״ל היא ספאם או לא. ככל שההסתברות גבוהה יותר, כך סביר יותר שההודעה שייכת למחלקה הזו.
היתרון הגדול של Naive Bayes הוא שהמימוש שלו מהיר ופשוט. הוא עובד היטב עם נתונים בעלי ממדיות גבוהה (כמו טקסט) ויכול להתמודד עם ערכים חסרים. עם זאת, הנחת אי-התלות אינה תמיד נכונה בחיים האמיתיים, ולכן לפעמים התוצאות פחות מדויקות בהשוואה לאלגוריתמים מורכבים יותר.
 בחנו את עצמכם
השיעור הזה כולל חידון קצר. התחילו את השיעור כדי לענות עליו ולעקוב אחרי ההתקדמות.
בחנו את עצמכםהשיעור הזה כולל חידון קצר. התחילו את השיעור כדי לענות עליו ולעקוב אחרי ההתקדמות.
בחנו את עצמכםהשיעור הזה כולל חידון קצר. התחילו את השיעור כדי לענות עליו ולעקוב אחרי ההתקדמות.

אתגר
בינוניבאתגר הזה נלמד איך לחשב את ההסתברות להשתייך למחלקה מסוימת. מערך הנתונים play_outside.csv מכיל את העמודות הבאות: temperature, mood, motivation, windy, play. כל שורה מייצגת את אותו אדם ואת השאלה אם הוא החליט לשחק בחוץ או לא, בהתבסס על מאפיינים (temperature, mood, motivation, windy). המטרה שלנו היא לחזות אם הוא יצא לשחק בחוץ בהתבסס על מאפיינים (temperature, mood, motivation, windy).
הנה דוגמה למערך נתונים:
| temperature | mood | motivation | windy | play |
| low | good | high | no | yes |
| moderate | good | high | no | yes |
| low | low | medium | yes | no |
המשוואות הבאות אולי נראות מאיימות, אבל נפרק אותן לשלבים.
נוסחת Naive Bayes: P(Class|Feature) = P(Feature|Class) * P(Class) / P(Feature)
- P(Feature|Class) - הסתברות הנראות
- P(Class) - ההסתברות המוקדמת של המחלקה
- P(Feature) - ההסתברות המוקדמת של המנבא
- P(Class|Feature) - במילים אחרות, מה ההסתברות שהשורה שטרם נצפתה תסווג למחלקה
<strong>x</strong>.
כדי לפתור את זה, נצטרך לחשב כל אחד מהרכיבים של הנוסחה (P(B|Class) * P(Class) / P(B))
- P(Class) - ההסתברות המוקדמת של המחלקה
הערך הזה שווה למספר ההופעות של כל מחלקה, חלקי המספר הכולל של המחלקות. לדוגמה, בדוגמה שלנו עם 3 שורות, יש2/3yes ו-1/3no.P(yes) = 2/3P(no) = 1/3 - P(Feature|Class) - הסתברות הנראות
הערך הזה שווה למספר ההופעות של כל מאפיין במחלקה נתונה. לדוגמה,P(temperature = <strong>low</strong>|play = <strong>yes</strong>)- יש שתי שורות שבהןplay = yes, ושורה אחת שבהtemperature = low(מבין השורות שבהןplay = yesבלבד), ולכן הערך הזה שווה ל-1/2. - P(Feature)
הערך הזה שווה למספר ההופעות של כל מאפיין חלקי המספר הכולל של השורות. לדוגמה:p(motivation=high) = 2/3כי יש שתי שורות עם מוטיבציה גבוהה, חלקי מספר השורות הכולל (3)
האתגר
ניתנות לך שתי מילוניות probability_features, probability_target ושם מערך הנתונים dataset_name
חשבו עבור כל מאפיין (עמודה) את ההסתברות של כל ערך.
לדוגמה, זהו הערך של probability_target:
probability_target = {
    "yes": 0.66667, # (2/3)
    "no": 0.33333 # (1/3)
}
זהו הערך של probability_features:
probability_features = {
	"temperature": {
		"low": {
			"yes": 0.5, # (1/2)
			"no": 0.5, # (1/2)
		},
		"moderate": {
			"yes": 1, # (1/1)
			"no": 0, # (0/1)
		}
	}
}
חשוב לזכור ששמות המאפיינים ושמות הערכים אינם קבועים. לכל מערך נתונים יש מאפיינים ושמות שונים.
מומלץ להשתמש במודול pandas כדי להקל על החישובים.
נסו בעצמכם
import pandas as pd
probability_features = {}
probability_target = {}
dataset_path = input()
target_variable = input()
df = pd.read_csv(dataset_path)
# כתבו כאן את הקוד שלכם


# -------------------- מיון והדפסה --------------------
# אל תשנו דבר מתחת לשורה זו
sort_features = {q: {k: v for k, v in sorted(a.items() if a != None else {}, key=lambda item: item[0])} for q, a in sorted(probability_features.items(), key=lambda item: item[0])}
sort_target = {k: v for k, v in sorted(probability_target.items(), key=lambda item: item[0])}
print(sort_features)
print(sort_target)כל השיעורים ביחידה מבוא ללמידת מכונה


תרגלו בעצמכם: קומפיילר Python אונליין