





Introduzione a Naive Bayes
Lezione 12 di 19 del corso Introduzione all’apprendimento automatico di Coddy.
Naive Bayes è un algoritmo semplice ma potente utilizzato per attività di classificazione nell'apprendimento automatico.
L'algoritmo Naive Bayes si basa sul teorema di Bayes, che ci spiega come calcolare la probabilità di un evento (come un'email che finisce nella posta indesiderata) sulla base delle conoscenze preliminari di condizioni che potrebbero essere correlate all'evento. La parte «naive» deriva dall'ipotesi che tutte le caratteristiche (come le parole nell'email) siano indipendenti l'una dall'altra, il che semplifica i calcoli. Essere indipendenti significa che il verificarsi di una cosa non cambia la probabilità che se ne verifichi un'altra.
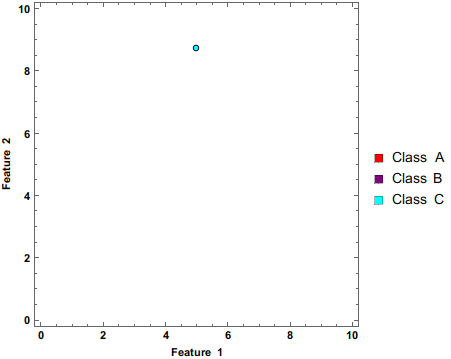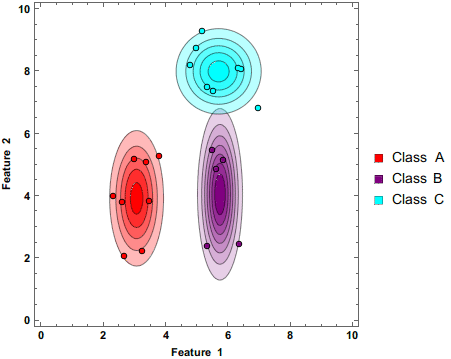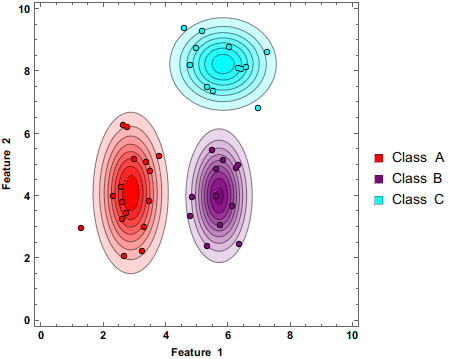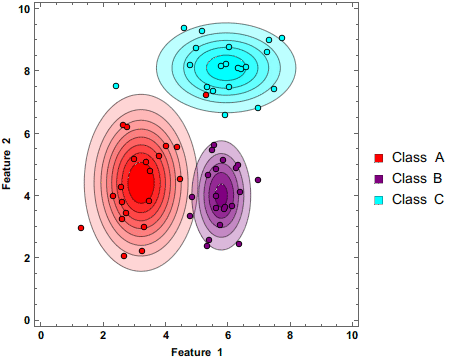
Fonte: Wikipedia, un classificatore Naive Bayes aggiorna la sua stima man mano che gli vengono forniti più dati.
Ecco come funziona:
- Conta le occorrenze: per prima cosa, conta quante volte ogni dato compare nelle diverse classi. Nel rilevamento dello spam nelle email, conteremo quante volte ogni parola compare nelle email di spam o non spam; nella diagnosi medica, potremmo contare quante volte (o per quanto tempo) compare ogni sintomo.
- Calcola le probabilità: per un nuovo dato, calcola la probabilità che appartenga a ciascuna classe (qual è la probabilità che una nuova email sia spam e qual è la probabilità che non sia spam)
- Decisione: infine, l'algoritmo combina tutte queste probabilità usando il teorema di Bayes e decide se è più probabile che l'email sia spam o non spam. Più alta è la probabilità, più è probabile che appartenga a questa classe.
L'aspetto interessante di Naive Bayes è che è veloce e facile da implementare. Funziona bene con dati ad alta dimensionalità (come il testo) e può gestire valori mancanti. Tuttavia, l'ipotesi di indipendenza non è sempre vera nella vita reale e talvolta può portare a risultati meno accurati rispetto ad algoritmi più complessi.
 Mettiti alla prova
Questa lezione include un breve quiz. Inizia la lezione per rispondere e tenere traccia dei tuoi progressi.
Mettiti alla provaQuesta lezione include un breve quiz. Inizia la lezione per rispondere e tenere traccia dei tuoi progressi.
Mettiti alla provaQuesta lezione include un breve quiz. Inizia la lezione per rispondere e tenere traccia dei tuoi progressi.

Sfida
MedioIn questa sfida impareremo a calcolare la probabilità di appartenere a una determinata classe. Il dataset play_outside.csv contiene le seguenti colonne: temperature, mood, motivation, windy, play. Ogni riga rappresenta la stessa persona e indica se ha deciso o meno di giocare all'aperto in base alle caratteristiche (temperature, mood, motivation, windy). Il nostro obiettivo è prevedere se andrà a giocare all'aperto in base alle caratteristiche (temperature, mood, motivation, windy).
Ecco un esempio di dataset:
| temperature | mood | motivation | windy | play |
| low | good | high | no | yes |
| moderate | good | high | no | yes |
| low | low | medium | yes | no |
Le equazioni seguenti potrebbero sembrare intimidatorie, ma le analizzeremo passo per passo.
Formula di Naive Bayes: P(Class|Feature) = P(Feature|Class) * P(Class) / P(Feature)
- P(Feature|Class) - Verosimiglianza
- P(Class) - Probabilità a priori della classe
- P(Feature) - Probabilità a priori del predittore
- P(Class|Feature) - In altre parole, qual è la probabilità che la riga non osservata venga classificata nella classe
<strong>x</strong>.
Per risolvere il problema, dovremo calcolare ciascuna componente della formula (P(B|Class) * P(Class) / P(B))
- P(Class) - Probabilità a priori della classe
È pari al numero di occorrenze di ciascuna classe diviso per il numero totale di classi. Ad esempio, nel nostro esempio di 3 righe, ci sono2/3yes e1/3no.P(yes) = 2/3P(no) = 1/3 - P(Feature|Class) - Verosimiglianza
È pari al numero di occorrenze di ciascuna caratteristica per una determinata classe. Ad esempioP(temperature = <strong>low</strong>|play = <strong>yes</strong>)- Ci sono due righe in cuiplay = yese una riga in cuitemperature = low(considerando solo le righe in cuiplay = yes), quindi il risultato è1/2. - P(Feature)
È pari al numero di occorrenze di ciascuna caratteristica diviso per il numero totale di righe. Ad esempio:p(motivation=high) = 2/3perché ci sono due righe con motivation alta, divise per il numero totale di righe (3)
La sfida
Ti vengono forniti due dizionari probability_features, probability_target e il dataset_name
Calcola la probabilità di ciascun attributo per ogni caratteristica (colonna).
Ecco, ad esempio, il valore di probability_target:
probability_target = {
    "yes": 0.66667, # (2/3)
    "no": 0.33333 # (1/3)
}
Ecco il valore di probability_features:
probability_features = {
	"temperature": {
		"low": {
			"yes": 0.5, # (1/2)
			"no": 0.5, # (1/2)
		},
		"moderate": {
			"yes": 1, # (1/1)
			"no": 0, # (0/1)
		}
	}
}
Tieni presente che i nomi delle caratteristiche e degli attributi non sono costanti. Ogni dataset ha caratteristiche e nomi diversi.
Ti consiglio di usare il modulo pandas per semplificare i calcoli.
Provalo tu
import pandas as pd
probability_features = {}
probability_target = {}
dataset_path = input()
target_variable = input()
df = pd.read_csv(dataset_path)
# Scrivi il tuo codice qui


# -------------------- Ordina e stampa --------------------
# Non modificare nulla sotto questa riga
sort_features = {q: {k: v for k, v in sorted(a.items() if a != None else {}, key=lambda item: item[0])} for q, a in sorted(probability_features.items(), key=lambda item: item[0])}
sort_target = {k: v for k, v in sorted(probability_target.items(), key=lambda item: item[0])}
print(sort_features)
print(sort_target)Tutte le lezioni di Introduzione all’apprendimento automatico


2Panoramica sull’apprendimento automatico
Apprendimento supervisionatoApprendimento non supervisionatoEsercitati da solo: Compilatore Python online