





Macchina a vettori di supporto (SVM)
Lezione 18 di 19 del corso Introduzione all’apprendimento automatico di Coddy.
La Support Vector Machine (SVM) è un algoritmo di machine learning supervisionato potente e versatile, utilizzato sia per attività di classificazione sia di regressione. Tuttavia, viene usato più comunemente nei problemi di classificazione. Le SVM offrono un'elevata accuratezza e funzionano bene con uno spazio delle caratteristiche ad alta dimensionalità, rendendole adatte ad applicazioni che vanno dal riconoscimento delle immagini alla bioinformatica.
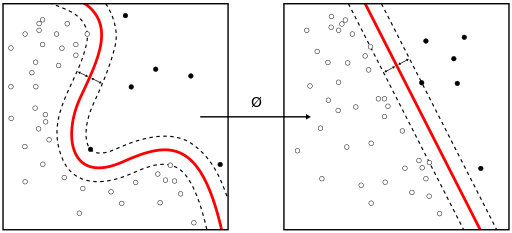
Fonte: wikipedia
L'obiettivo principale dell'algoritmo SVM è trovare l'iperpiano ottimale (in uno spazio bidimensionale, una retta) che separa al meglio le classi nello spazio delle caratteristiche. Il modello SVM rappresenta gli esempi come punti nello spazio, mappati in modo tale che gli esempi delle diverse categorie siano separati da un margine netto il più ampio possibile.
- Iperpiano: è fondamentalmente un confine decisionale che separa le classi. In 2D, questo iperpiano è una retta, ma in dimensioni superiori può essere più complesso.
- Vettori di supporto: sono i punti dati più vicini all'iperpiano, fondamentali per definirne la posizione. Il classificatore SVM è fortemente influenzato da questi punti, da cui il nome
Support VectorMachine. - Margine: è la distanza tra due rette che passano per i punti dati più vicini appartenenti a classi diverse. Può essere considerato una misura della separazione tra le classi. Garantire che il margine sia il più ampio possibile è un obiettivo fondamentale nell'addestramento di una SVM.
Tipi di SVM:
- SVM lineare: quando i dati sono separabili linearmente, possiamo usare una singola retta per separare le classi. In questo caso si usa una SVM lineare.
- SVM non lineare: quando i dati non sono separabili linearmente, la SVM usa il cosiddetto trucco del kernel per trasformare lo spazio di input in uno spazio a dimensionalità superiore, nel quale è possibile usare un iperpiano per effettuare la separazione. Il trucco del kernel consiste nel trasformare i dati in un'altra dimensione in cui esiste un margine netto tra le classi di dati. Ciò consente alla SVM di risolvere problemi non lineari. I kernel più comuni includono:
- Kernel lineare: usato quando i dati sono separabili linearmente.
- Kernel polinomiale: trasforma lo spazio delle caratteristiche originale in uno spazio delle caratteristiche polinomiale di grado specificato.
- Kernel gaussiano: utile per dati non lineari che si raggruppano in cluster. Mappa lo spazio delle caratteristiche in dimensioni superiori.
 Mettiti alla prova
Questa lezione include un breve quiz. Inizia la lezione per rispondere e tenere traccia dei tuoi progressi.
Mettiti alla provaQuesta lezione include un breve quiz. Inizia la lezione per rispondere e tenere traccia dei tuoi progressi.
Mettiti alla provaQuesta lezione include un breve quiz. Inizia la lezione per rispondere e tenere traccia dei tuoi progressi.

Sfida
FacileLe Support Vector Machine (SVM) utilizzano funzioni kernel per trasformare i dati in uno spazio a dimensionalità maggiore, dove è più facile classificarli. Questo processo è noto come "kernel trick". Consente agli SVM di risolvere in modo efficiente problemi di classificazione e regressione non lineari.
Qui esploreremo il kernel polinomiale, che consente di ottenere confini curvi nei dati. Eleva i dati a un grado specificato d. Questo kernel è particolarmente utile quando la relazione tra le etichette di classe e gli attributi è polinomiale.
Fonte: wikipedia
Crea una funzione denominata polynomial_kernel che riceve due liste (x, y), un grado (d) e un coefficiente (c), e restituisce il kernel polinomiale.

x prodotto scalare trasposto y più c ) elevato alla potenza di d.
Provalo tu
import numpy as np
def polynomial_kernel(x, y, d, c):
    x_arr = np.array(x)
    y_arr = np.array(y)
# Scrivi il tuo codice quiTutte le lezioni di Introduzione all’apprendimento automatico


2Panoramica sull’apprendimento automatico
Apprendimento supervisionatoApprendimento non supervisionato6Altri modelli
Regressione logisticaRegressione lineareAlbero decisionaleMacchina a vettori di supporto (SVM)Quiz sui modelliEsercitati da solo: Compilatore Python online