





Wprowadzenie do KNN
Lekcja 6 z 19 w kursie Wprowadzenie do uczenia maszynowego w Coddy.
K-najbliższych sąsiadów (KNN) to algorytm uczenia nadzorowanego, który jest używany zarówno do problemów klasyfikacji, jak i regresji. Jest prosty, a zarazem skuteczny, i często służy jako punkt odniesienia dla bardziej złożonych modeli.
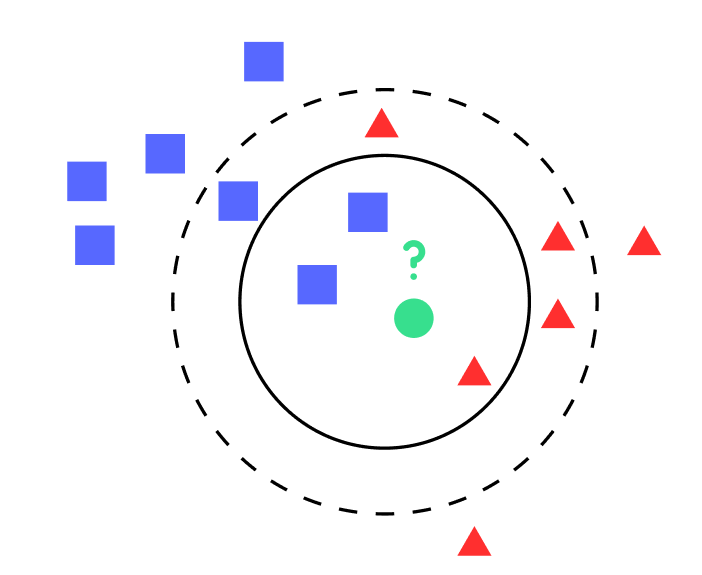
Algorytm KNN określa podobieństwo cech za pomocą miar odległości, aby znaleźć najbliższych sąsiadów danego punktu. Na przykład może sortować wina, porównując je z najbardziej podobnymi, na przykład grupując razem wina o podobnym smaku. To tak, jakby mieć przewodnika, który pomaga znaleźć podobne wina na podstawie ich najczęstszych cech. 🍷
Idea stojąca za KNN jest dość prosta:
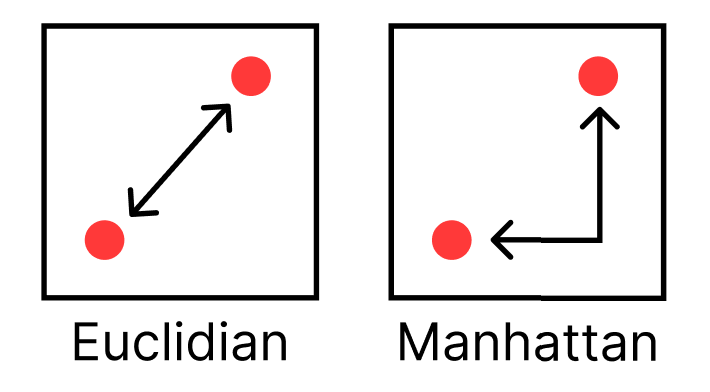
- Obliczanie odległości: Dla danego punktu testowego algorytm oblicza odległość między tym punktem a każdym innym punktem w zbiorze danych treningowych. Odległość można obliczyć na różne sposoby, na przykład jako odległość euklidesową lub Manhattan.
- Znajdowanie najbliższych sąsiadów: Następnie algorytm wybiera
kpunktów w danych treningowych, które znajdują się najbliżej punktu testowego.kjest stałą określaną przez użytkownika i może być dowolną liczbą całkowitą. - Przewidywanie: W przypadku klasyfikacji algorytm przypisuje punktowi testowemu najczęściej występującą etykietę klasy spośród
knajbliższych sąsiadów. W przypadku regresji przypisuje średnią z wartości ‘k’ najbliższych sąsiadów.
KNN to algorytm leniwego uczenia, co oznacza, że w rzeczywistości nie uczy się modelu. Zamiast tego zapamiętuje przykłady treningowe i wykorzystuje je do przewidywania (faza treningu zostanie omówiona na następnej lekcji). To sprawia, że KNN jest kosztowny obliczeniowo podczas fazy testowania.
Mimo swojej prostoty KNN może osiągać zaskakująco dobre wyniki. Jest jednak wrażliwy na wybór k i rodzaj miary odległości, a także nie radzi sobie dobrze z danymi o wysokim wymiarze z powodu przekleństwa wymiarowości.
 Sprawdź się
Ta lekcja zawiera krótki quiz. Zacznij lekcję, żeby na niego odpowiedzieć i śledzić swoje postępy.
Sprawdź sięTa lekcja zawiera krótki quiz. Zacznij lekcję, żeby na niego odpowiedzieć i śledzić swoje postępy.
Sprawdź sięTa lekcja zawiera krótki quiz. Zacznij lekcję, żeby na niego odpowiedzieć i śledzić swoje postępy.

Wyzwanie
ŁatwyW tym wyzwaniu poznamy różne sposoby obliczania odległości.
Utwórz funkcję o nazwie distances_option_calculator, która otrzymuje trzy zmienne: X, y i distance_type. Funkcja zwróci odległość między X a y zgodnie z wartością distance_type.
Oto lista popularnych sposobów obliczania odległości:
Odległość euklidesowa (najpopularniejsza) to odległość w linii prostej między dwoma punktami. Jest to pierwiastek kwadratowy z sumy kwadratów różnic między każdą parą odpowiadających sobie współrzędnych punktów:
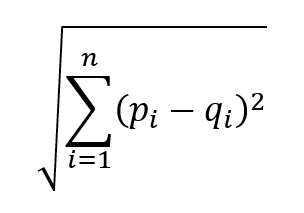
Odległość Manhattan jest również znana jako odległość taksówkowa lub miejska. To suma wartości bezwzględnych różnic między punktami we wszystkich wymiarach. Dla dwóch punktów ( P ) i ( Q ) o współrzędnych odpowiednio ( (p_1, p_2, …, p_n) ) i ( (q_1, q_2, …, q_n) ):
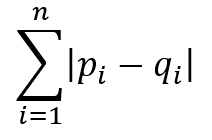
Odległość Hamminga: liczba pozycji, na których odpowiadające sobie symbole są różne. Często stosuje się ją do danych kategorycznych.
Na przykład weźmy dwa ciągi binarne:
String 1: 1101
String 2: 1001
Porównując je pozycja po pozycji, widzimy, że bity na drugiej pozycji są różne (1 w String 1 i 0 w String 2). Wszystkie pozostałe pozycje są takie same. Zatem odległość Hamminga między tymi dwoma ciągami wynosi 1.
distance_type może przyjmować następujące wartości: hamming, manhattan, euclidian.
Spróbuj swoich sił
def distances_option_calculator(X, y, distance_type):
    # Wpisz kod tutaj
    if distance_type == "euclidian":
        pass
    elif distance_type == "manhattan":
        pass
    elif distance_type == "hamming":
passWszystkie lekcje w sekcji Wprowadzenie do uczenia maszynowego

Poćwicz samodzielnie: Kompilator Python online