





Maszyna wektorów nośnych (SVM)
Lekcja 18 z 19 w kursie Wprowadzenie do uczenia maszynowego w Coddy.
Maszyna wektorów nośnych (SVM) to wydajny i wszechstronny nadzorowany algorytm uczenia maszynowego, wykorzystywany zarówno do zadań klasyfikacji, jak i regresji. Częściej stosuje się go jednak w problemach klasyfikacji. SVM zapewnia wysoką dokładność i dobrze sprawdza się w przestrzeni cech o wysokim wymiarze, dzięki czemu nadaje się do zastosowań obejmujących zarówno rozpoznawanie obrazów, jak i bioinformatykę.
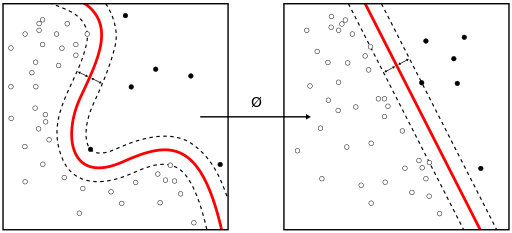
Źródło: wikipedia
Głównym celem algorytmu SVM jest znalezienie optymalnej hiperpłaszczyzny (w przestrzeni dwuwymiarowej jest to prosta), która najlepiej rozdziela klasy w przestrzeni cech. Model SVM przedstawia przykłady jako punkty w przestrzeni, odwzorowane w taki sposób, aby przykłady należące do różnych kategorii były oddzielone wyraźnym odstępem, który jest jak najszerszy.
- Hiperpłaszczyzna: To zasadniczo granica decyzyjna oddzielająca klasy. W przestrzeni 2D ta hiperpłaszczyzna jest prostą, ale w wyższych wymiarach może być bardziej złożona.
- Wektory nośne: Są to punkty danych położone najbliżej hiperpłaszczyzny, które mają kluczowe znaczenie dla określenia jej położenia. Te punkty mają duży wpływ na klasyfikator SVM, stąd nazwa
Support VectorMachine. - Margines: Jest to odstęp między dwiema liniami wyznaczonymi przez najbliższe punkty danych należące do różnych klas. Można go uznać za miarę separacji między klasami. Zapewnienie jak najszerszego marginesu jest jednym z kluczowych celów trenowania SVM.
Rodzaje SVM:
- Liniowe SVM: Gdy dane są liniowo separowalne, możemy użyć jednej prostej do rozdzielenia klas. W takim przypadku stosuje się liniowe SVM.
- Nieliniowe SVM: Gdy dane nie są liniowo separowalne, SVM wykorzystuje tak zwaną sztuczkę jądra, aby przekształcić przestrzeń wejściową w przestrzeń o wyższym wymiarze, w której można rozdzielić dane za pomocą hiperpłaszczyzny. Sztuczka jądra polega na przekształceniu danych do innego wymiaru, w którym klasy danych są wyraźnie oddzielone marginesem. Dzięki temu SVM może rozwiązywać problemy nieliniowe. Do popularnych jąder należą:
- Jądro liniowe: Stosowane, gdy dane są liniowo separowalne.
- Jądro wielomianowe: Przekształca oryginalną przestrzeń cech w wielomianową przestrzeń cech o określonym stopniu.
- Jądro Gaussa: Przydatne w przypadku danych nieliniowych, które grupują się w klastry. Odwzorowuje przestrzeń cech na przestrzeń o wyższych wymiarach.
 Sprawdź się
Ta lekcja zawiera krótki quiz. Zacznij lekcję, żeby na niego odpowiedzieć i śledzić swoje postępy.
Sprawdź sięTa lekcja zawiera krótki quiz. Zacznij lekcję, żeby na niego odpowiedzieć i śledzić swoje postępy.
Sprawdź sięTa lekcja zawiera krótki quiz. Zacznij lekcję, żeby na niego odpowiedzieć i śledzić swoje postępy.

Wyzwanie
ŁatwyMaszyny wektorów nośnych (SVM) wykorzystują funkcje jądra do przekształcania danych w przestrzeń o wyższym wymiarze, w której łatwiej je sklasyfikować. Ten proces jest znany jako „sztuczka z jądrem”. Pozwala ona maszynom SVM efektywnie rozwiązywać nieliniowe problemy klasyfikacji i regresji.
Przyjrzymy się tutaj jądru wielomianowemu, które pozwala uzyskać zakrzywione granice w danych. Podnosi ono dane do określonego stopnia d. To jądro jest szczególnie przydatne, gdy zależność między etykietami klas a atrybutami ma charakter wielomianowy.
Źródło: Wikipedia
Utwórz funkcję o nazwie polynomial_kernel, która przyjmuje dwie listy (x, y), stopień (d) i współczynnik (c), a następnie zwraca jądro wielomianowe.

x transponowanego i y plus c, podniesiony do potęgi d.
Spróbuj swoich sił
import numpy as np
def polynomial_kernel(x, y, d, c):
    x_arr = np.array(x)
    y_arr = np.array(y)
# Wpisz tutaj swój kodWszystkie lekcje w sekcji Wprowadzenie do uczenia maszynowego


6Inne modele
Regresja logistycznaRegresja liniowaDrzewo decyzyjneMaszyna wektorów nośnych (SVM)Quiz o modelachPoćwicz samodzielnie: Kompilator Python online