





Wprowadzenie do algorytmu naiwnego Bayesa
Lekcja 12 z 19 w kursie Wprowadzenie do uczenia maszynowego w Coddy.
Naiwny Bayes to prosty, ale skuteczny algorytm używany do zadań klasyfikacji w uczeniu maszynowym.
Algorytm naiwny Bayes opiera się na twierdzeniu Bayesa, które mówi nam, jak obliczyć prawdopodobieństwo zdarzenia (na przykład tego, że wiadomość e-mail jest spamem) na podstawie wcześniejszej wiedzy o warunkach, które mogą być związane z tym zdarzeniem. „Naiwna” część nazwy wynika z założenia, że wszystkie cechy (na przykład słowa w wiadomości e-mail) są od siebie niezależne, co upraszcza obliczenia. Niezależność oznacza, że wystąpienie jednej rzeczy nie zmienia prawdopodobieństwa wystąpienia innej.
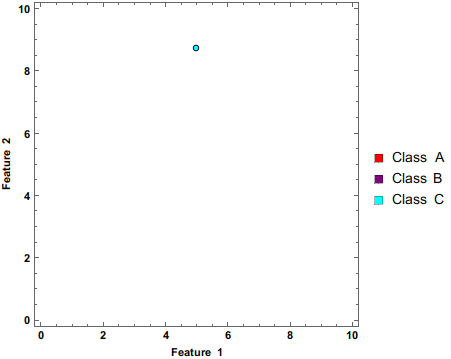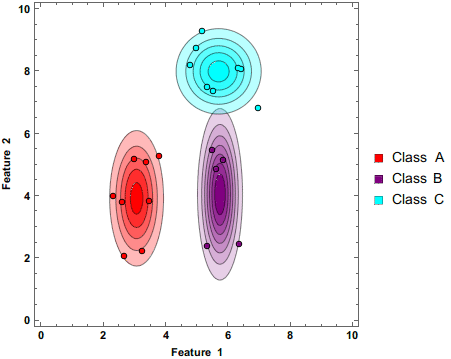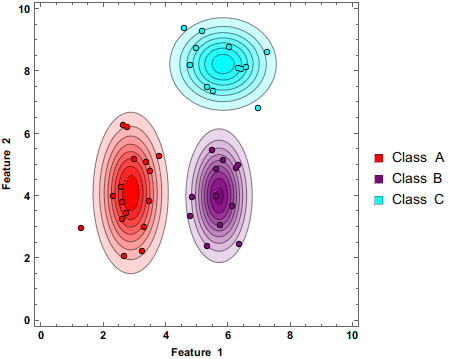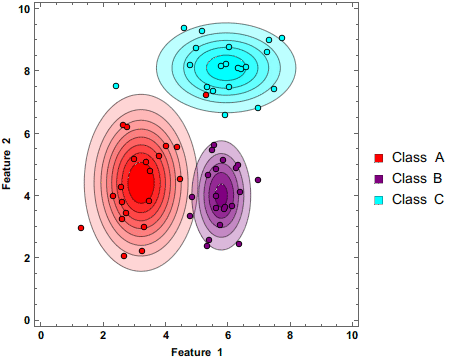
Źródło: Wikipedia, klasyfikator naiwny Bayesa aktualizujący swoje oszacowanie w miarę dostarczania kolejnych danych.
Oto jak to działa:
- Policz wystąpienia: Najpierw policz, ile razy każdy punkt danych pojawia się w różnych klasach. W wykrywaniu spamu w wiadomościach e-mail policzymy, ile razy każde słowo wystąpiło w wiadomościach będących spamem lub niebędących spamem; w diagnozowaniu medycznym możemy policzyć, ile razy (lub jak długo) występuje każdy objaw.
- Oblicz prawdopodobieństwa: Dla nowego punktu danych oblicz prawdopodobieństwo przynależności do każdej klasy (jakie jest prawdopodobieństwo, że nowa wiadomość e-mail jest spamem, a jakie, że nim nie jest)
- Decyzja: Na koniec algorytm łączy wszystkie te prawdopodobieństwa, korzystając z twierdzenia Bayesa, i decyduje, czy wiadomość e-mail z większym prawdopodobieństwem jest spamem, czy nim nie jest. Im wyższe prawdopodobieństwo, tym większa szansa, że należy do tej klasy.
Zaletą naiwnego Bayesa jest szybka i łatwa implementacja. Dobrze sprawdza się w przypadku danych o dużej liczbie wymiarów (takich jak tekst) i potrafi obsługiwać brakujące wartości. Jednak założenie o niezależności nie zawsze jest prawdziwe w rzeczywistości, co czasami może prowadzić do mniej dokładnych wyników niż w przypadku bardziej złożonych algorytmów.
 Sprawdź się
Ta lekcja zawiera krótki quiz. Zacznij lekcję, żeby na niego odpowiedzieć i śledzić swoje postępy.
Sprawdź sięTa lekcja zawiera krótki quiz. Zacznij lekcję, żeby na niego odpowiedzieć i śledzić swoje postępy.
Sprawdź sięTa lekcja zawiera krótki quiz. Zacznij lekcję, żeby na niego odpowiedzieć i śledzić swoje postępy.

Wyzwanie
ŚredniW tym wyzwaniu nauczymy się obliczać prawdopodobieństwo przynależności do określonej klasy. Zbiór danych play_outside.csv zawiera następujące kolumny: temperature, mood, motivation, windy, play. Każdy wiersz opisuje tę samą osobę i to, czy zdecydowała się wyjść na zewnątrz, czy nie, na podstawie cech (temperature, mood, motivation, windy). Naszym celem jest przewidzenie, czy wyjdzie ona na zewnątrz, na podstawie cech (temperature, mood, motivation, windy).
Oto przykład zbioru danych:
| temperature | mood | motivation | windy | play |
| low | good | high | no | yes |
| moderate | good | high | no | yes |
| low | low | medium | yes | no |
Poniższe równania mogą wydawać się onieśmielające, ale omówimy je krok po kroku.
Wzór naiwnego Bayesa: P(Class|Feature) = P(Feature|Class) * P(Class) / P(Feature)
- P(Feature|Class) - wiarygodność
- P(Class) - prawdopodobieństwo a priori klasy
- P(Feature) - prawdopodobieństwo a priori predyktora
- P(Class|Feature) - Innymi słowy, jakie jest prawdopodobieństwo, że niewidziany wiersz zostanie przypisany do klasy
<strong>x</strong>.
Aby to rozwiązać, musimy obliczyć każdy ze składników wzoru (P(B|Class) * P(Class) / P(B))
- P(Class) - prawdopodobieństwo a priori klasy
Jest to liczba wystąpień każdej klasy podzielona przez łączną liczbę klas. Na przykład w naszym przykładzie z 3 wierszami mamy2/3yes i1/3no.P(yes) = 2/3P(no) = 1/3 - P(Feature|Class) - wiarygodność
Jest to liczba wystąpień każdej cechy dla danej klasy. Na przykładP(temperature = <strong>low</strong>|play = <strong>yes</strong>)— są dwa wiersze, w którychplay = yes, i jeden wiersz, w którymtemperature = low(spośród wierszy, w którychplay = yes), więc wynik wynosi1/2. - P(Feature)
Jest to liczba wystąpień każdej cechy podzielona przez łączną liczbę wierszy. Na przykład:p(motivation=high) = 2/3, ponieważ są dwa wiersze z wysoką motywacją, podzielone przez łączną liczbę wierszy (3)
Wyzwanie
Otrzymujesz dwa słowniki probability_features, probability_target oraz dataset_name
Oblicz prawdopodobieństwo każdej wartości dla każdej cechy (kolumny).
Oto przykładowa wartość probability_target:
probability_target = {
    "yes": 0.66667, # (2/3)
    "no": 0.33333 # (1/3)
}
Oto wartość probability_features:
probability_features = {
	"temperature": {
		"low": {
			"yes": 0.5, # (1/2)
			"no": 0.5, # (1/2)
		},
		"moderate": {
			"yes": 1, # (1/1)
			"no": 0, # (0/1)
		}
	}
}
Pamiętaj, że nazwy cech i wartości atrybutów nie są stałe. Każdy zbiór danych ma inne cechy i inne nazwy.
Do ułatwienia obliczeń polecam skorzystać z modułu pandas.
Spróbuj swoich sił
import pandas as pd
probability_features = {}
probability_target = {}
dataset_path = input()
target_variable = input()
df = pd.read_csv(dataset_path)
# Wpisz tutaj swój kod


# -------------------- Posortuj i wypisz --------------------
# Nie zmieniaj niczego poniżej tej linii
sort_features = {q: {k: v for k, v in sorted(a.items() if a != None else {}, key=lambda item: item[0])} for q, a in sorted(probability_features.items(), key=lambda item: item[0])}
sort_target = {k: v for k, v in sorted(probability_target.items(), key=lambda item: item[0])}
print(sort_features)
print(sort_target)Wszystkie lekcje w sekcji Wprowadzenie do uczenia maszynowego


Poćwicz samodzielnie: Kompilator Python online