





Giới thiệu về KNN
Bài học 6 trên 19 trong khóa học Giới thiệu về học máy của Coddy.
K-Nearest Neighbors (KNN) là một thuật toán học có giám sát (supervised learning), được dùng cho cả bài toán phân loại và hồi quy. Thuật toán này đơn giản nhưng mạnh mẽ, thường được dùng làm mô hình cơ sở để so sánh với các mô hình phức tạp hơn.
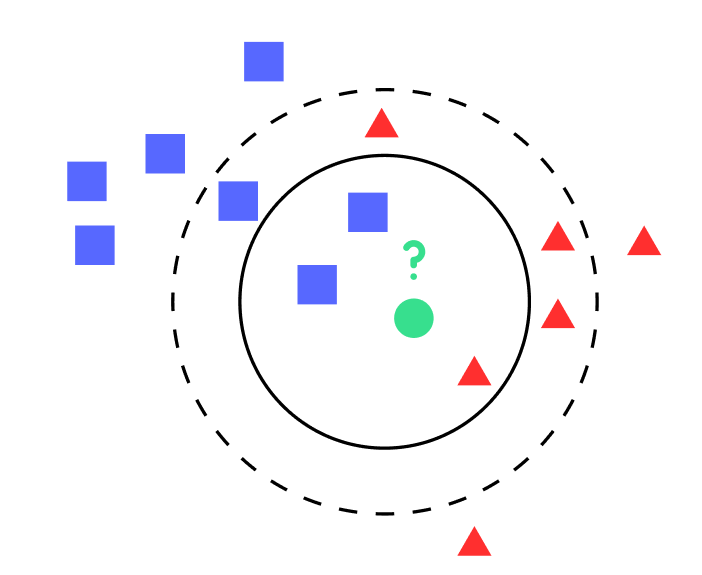
Thuật toán KNN tìm các đặc trưng tương đồng bằng cách dùng thước đo khoảng cách (distance metric) để xác định những điểm lân cận gần nhất với một điểm. Ví dụ, thuật toán có thể phân loại rượu vang bằng cách so sánh từng loại với những loại gần giống nhất, chẳng hạn nhóm các loại rượu có hương vị tương tự vào cùng một nhóm. Thuật toán giống như một người hướng dẫn giúp bạn tìm ra những loại rượu vang giống nhau dựa trên các đặc điểm chung nhất. 🍷
Ý tưởng đằng sau KNN khá đơn giản:
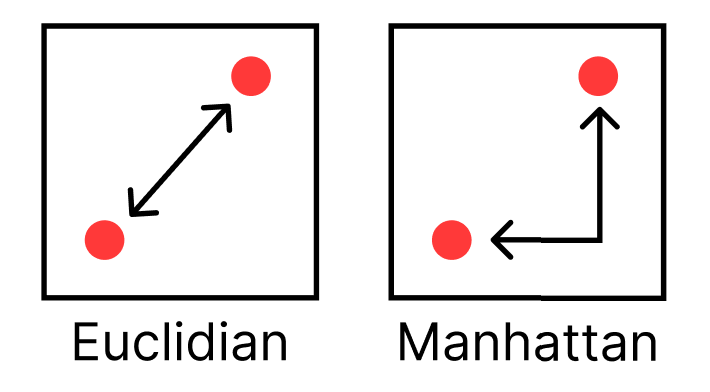
- Tính khoảng cách: Với một điểm kiểm tra, thuật toán tính khoảng cách giữa điểm đó và mọi điểm khác trong tập dữ liệu huấn luyện. Có thể tính khoảng cách theo nhiều cách, chẳng hạn như khoảng cách Euclid hoặc khoảng cách Manhattan.
- Tìm các điểm lân cận gần nhất: Sau đó, thuật toán chọn
kđiểm trong dữ liệu huấn luyện gần điểm kiểm tra nhất. Người dùng xác định hằng sốk, vàkcó thể là bất kỳ số nguyên nào. - Đưa ra dự đoán: Với bài toán phân loại, thuật toán gán cho điểm kiểm tra nhãn lớp xuất hiện nhiều nhất trong số
kđiểm lân cận gần nhất. Với bài toán hồi quy, thuật toán gán giá trị trung bình củakđiểm lân cận gần nhất.
KNN là thuật toán học lười (lazy learning), nghĩa là thuật toán không thực sự học một mô hình. Thay vào đó, thuật toán ghi nhớ các mẫu dữ liệu huấn luyện và dùng chúng để dự đoán. Bài học tiếp theo sẽ trình bày giai đoạn huấn luyện. Vì vậy, KNN đòi hỏi nhiều tài nguyên tính toán trong giai đoạn kiểm tra.
Dù đơn giản, KNN vẫn có thể đạt hiệu suất tốt ngoài mong đợi. Tuy nhiên, thuật toán nhạy với lựa chọn k và loại thước đo khoảng cách. Thuật toán cũng hoạt động không tốt với dữ liệu có nhiều chiều do lời nguyền số chiều.
 Tự kiểm tra
Bài học này có một bài trắc nghiệm ngắn. Bắt đầu bài học để trả lời và theo dõi tiến độ.
Tự kiểm traBài học này có một bài trắc nghiệm ngắn. Bắt đầu bài học để trả lời và theo dõi tiến độ.
Tự kiểm traBài học này có một bài trắc nghiệm ngắn. Bắt đầu bài học để trả lời và theo dõi tiến độ.

Thử thách
DễTrong thử thách này, chúng ta sẽ tìm hiểu các cách tính khoảng cách khác nhau.
Tạo một hàm (function) có tên distances_option_calculator nhận ba biến: X, y và distance_type. Hàm sẽ trả về khoảng cách giữa X và y dựa trên distance_type.
Dưới đây là danh sách các cách tính khoảng cách phổ biến:
Khoảng cách Euclidian (phổ biến nhất) là khoảng cách theo đường thẳng giữa hai điểm. Khoảng cách này bằng căn bậc hai của tổng bình phương độ chênh lệch giữa từng tọa độ tương ứng của hai điểm:
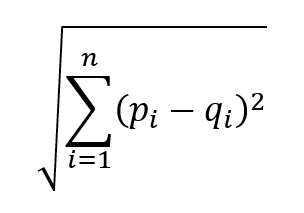
Khoảng cách Manhattan còn được gọi là khoảng cách Taxicab hoặc khoảng cách City Block. Đây là tổng độ chênh lệch tuyệt đối giữa các điểm trên tất cả các chiều. Với hai điểm ( P ) và ( Q ), có tọa độ lần lượt là ( (p_1, p_2, …, p_n) ) và ( (q_1, q_2, …, q_n) ):
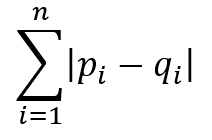
Khoảng cách Hamming là số vị trí có các ký hiệu tương ứng khác nhau. Khoảng cách này thường được dùng cho dữ liệu phân loại.
Ví dụ, hãy xét hai chuỗi nhị phân:
String 1: 1101
String 2: 1001
Khi so sánh từng vị trí, ta thấy các bit ở vị trí thứ hai khác nhau (1 trong String 1 và 0 trong String 2). Các vị trí còn lại đều giống nhau. Vì vậy, khoảng cách Hamming giữa hai chuỗi này là 1.
distance_type có thể nhận các giá trị sau: hamming, manhattan, euclidian.
Tự làm thử
def distances_option_calculator(X, y, distance_type):
    # Viết code tại đây
    if distance_type == "euclidian":
        pass
    elif distance_type == "manhattan":
        pass
    elif distance_type == "hamming":
passTất cả bài học trong Giới thiệu về học máy

Tự luyện tập: Trình biên dịch Python online