





Giới thiệu về Naive Bayes
Bài học 12 trên 19 trong khóa học Giới thiệu về học máy của Coddy.
Naive Bayes là một thuật toán đơn giản nhưng mạnh mẽ, dùng cho các tác vụ phân loại trong học máy.
Thuật toán Naive Bayes dựa trên định lý Bayes, cho biết cách tính xác suất của một sự kiện, chẳng hạn như một email có phải là spam hay không, dựa trên kiến thức trước đó về những điều kiện có thể liên quan đến sự kiện đó. Phần “ngây thơ” xuất phát từ giả định rằng mọi đặc trưng (feature), chẳng hạn như các từ trong email, đều độc lập với nhau, giúp đơn giản hóa việc tính toán. Độc lập nghĩa là việc một điều xảy ra không làm thay đổi khả năng một điều khác xảy ra.
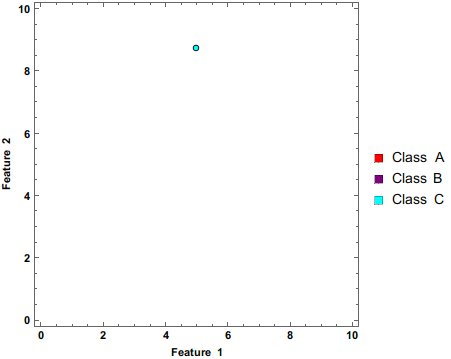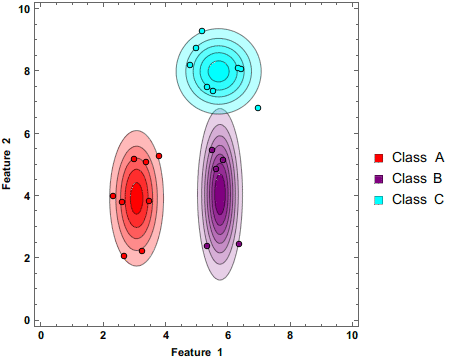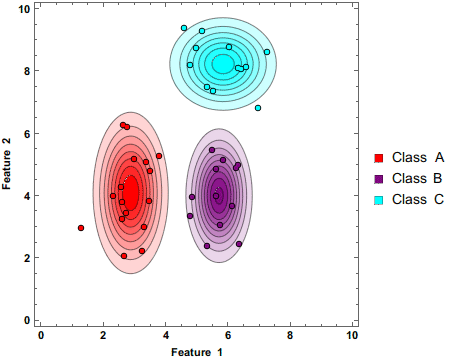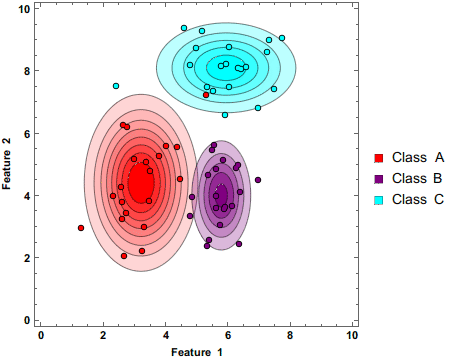
Nguồn: Wikipedia, bộ phân loại Naive Bayes cập nhật ước tính khi có thêm dữ liệu được đưa vào.
Cách hoạt động như sau:
- Đếm số lần xuất hiện: Trước tiên, hãy đếm số lần mỗi điểm dữ liệu xuất hiện trong các lớp khác nhau. Khi phát hiện email spam, ta sẽ đếm số lần mỗi từ xuất hiện trong email spam hoặc không phải spam. Trong chẩn đoán y tế, ta có thể đếm số lần (hoặc thời gian) mỗi triệu chứng xuất hiện.
- Tính xác suất: Với một điểm dữ liệu mới, hãy tính xác suất điểm đó thuộc về từng lớp (xác suất một email mới là spam và xác suất email đó không phải spam)
- Đưa ra quyết định: Cuối cùng, thuật toán kết hợp tất cả các xác suất này bằng định lý Bayes và quyết định email có khả năng là spam hay không phải spam cao hơn. Xác suất càng cao thì khả năng điểm dữ liệu thuộc lớp đó càng lớn.
Điểm hay của Naive Bayes là thuật toán này nhanh và dễ triển khai. Thuật toán hoạt động tốt với dữ liệu có nhiều chiều, chẳng hạn như văn bản, và có thể xử lý các giá trị bị thiếu. Tuy nhiên, giả định về tính độc lập không phải lúc nào cũng đúng trong thực tế, nên đôi khi kết quả kém chính xác hơn so với các thuật toán phức tạp hơn.
 Tự kiểm tra
Bài học này có một bài trắc nghiệm ngắn. Bắt đầu bài học để trả lời và theo dõi tiến độ.
Tự kiểm traBài học này có một bài trắc nghiệm ngắn. Bắt đầu bài học để trả lời và theo dõi tiến độ.
Tự kiểm traBài học này có một bài trắc nghiệm ngắn. Bắt đầu bài học để trả lời và theo dõi tiến độ.

Thử thách
Trung bìnhTrong thử thách này, chúng ta sẽ học cách tính xác suất một trường hợp thuộc về một lớp cụ thể. Tập dữ liệu play_outside.csv có các cột sau: temperature, mood, motivation, windy, play. Mỗi hàng thể hiện cùng một người và việc người đó có quyết định ra ngoài chơi hay không dựa trên các đặc trưng (temperature, mood, motivation, windy). Mục tiêu của chúng ta là dự đoán người đó có ra ngoài chơi hay không dựa trên các đặc trưng (temperature, mood, motivation, windy).
Đây là ví dụ về một tập dữ liệu:
| temperature | mood | motivation | windy | play |
| low | good | high | no | yes |
| moderate | good | high | no | yes |
| low | low | medium | yes | no |
Các công thức sau có thể trông khó hiểu, nhưng chúng ta sẽ phân tích từng phần.
Công thức Naive Bayes: P(Class|Feature) = P(Feature|Class) * P(Class) / P(Feature)
- P(Feature|Class) - Khả năng xảy ra
- P(Class) - Xác suất tiên nghiệm của lớp
- P(Feature) - Xác suất tiên nghiệm của đặc trưng dự đoán
- P(Class|Feature) - Nói cách khác, xác suất hàng chưa được xem sẽ được phân loại vào lớp
<strong>x</strong>là bao nhiêu.
Để giải bài này, chúng ta cần tính từng thành phần của công thức (P(B|Class) * P(Class) / P(B))
- P(Class) - Xác suất tiên nghiệm của lớp
Giá trị này bằng số lần xuất hiện của mỗi lớp chia cho tổng số lớp. Ví dụ, trong tập dữ liệu gồm 3 hàng, có2/3trường hợp yes và1/3trường hợp no.P(yes) = 2/3P(no) = 1/3 - P(Feature|Class) - Khả năng xảy ra
Giá trị này bằng số lần xuất hiện của mỗi đặc trưng trong một lớp nhất định. Ví dụ:P(temperature = <strong>low</strong>|play = <strong>yes</strong>)- Có hai hàng cóplay = yes, và một hàng cótemperature = low(chỉ tính trong các hàng cóplay = yes), nên giá trị này bằng1/2. - P(Feature)
Giá trị này bằng số lần xuất hiện của mỗi đặc trưng chia cho tổng số hàng. Ví dụ:p(motivation=high) = 2/3vì có hai hàng có mức động lực cao, chia cho tổng số hàng (3)
Thử thách
Bạn được cung cấp hai từ điển probability_features, probability_target và dataset_name
Tính xác suất của từng thuộc tính cho mỗi đặc trưng (cột).
Ví dụ, đây là giá trị của probability_target:
probability_target = {
    "yes": 0.66667, # (2/3)
    "no": 0.33333 # (1/3)
}
Đây là giá trị của probability_features:
probability_features = {
	"temperature": {
		"low": {
			"yes": 0.5, # (1/2)
			"no": 0.5, # (1/2)
		},
		"moderate": {
			"yes": 1, # (1/1)
			"no": 0, # (0/1)
		}
	}
}
Lưu ý rằng tên các đặc trưng và tên các thuộc tính không cố định. Mỗi tập dữ liệu có các đặc trưng và tên gọi khác nhau.
Mình khuyên bạn nên dùng module pandas để việc tính toán dễ dàng hơn.
Tự làm thử
import pandas as pd
probability_features = {}
probability_target = {}
dataset_path = input()
target_variable = input()
df = pd.read_csv(dataset_path)
# Viết code của bạn tại đây


# Sắp xếp và in ra
# Không thay đổi phần bên dưới dòng này
sort_features = {q: {k: v for k, v in sorted(a.items() if a != None else {}, key=lambda item: item[0])} for q, a in sorted(probability_features.items(), key=lambda item: item[0])}
sort_target = {k: v for k, v in sorted(probability_target.items(), key=lambda item: item[0])}
print(sort_features)
print(sort_target)Tất cả bài học trong Giới thiệu về học máy


Tự luyện tập: Trình biên dịch Python online