





مقدمة إلى KNN
الدرس 6 من 19 في دورة مقدمة في تعلم الآلة على Coddy.
خوارزمية الجيران الأقرب (K-Nearest Neighbors - KNN) هي خوارزمية تعلم خاضع للإشراف تُستخدم لكل من مشكلات التصنيف والانحدار. إنها بسيطة لكنها قوية وغالباً ما تُستخدم كخط أساس للنماذج الأكثر تعقيداً.
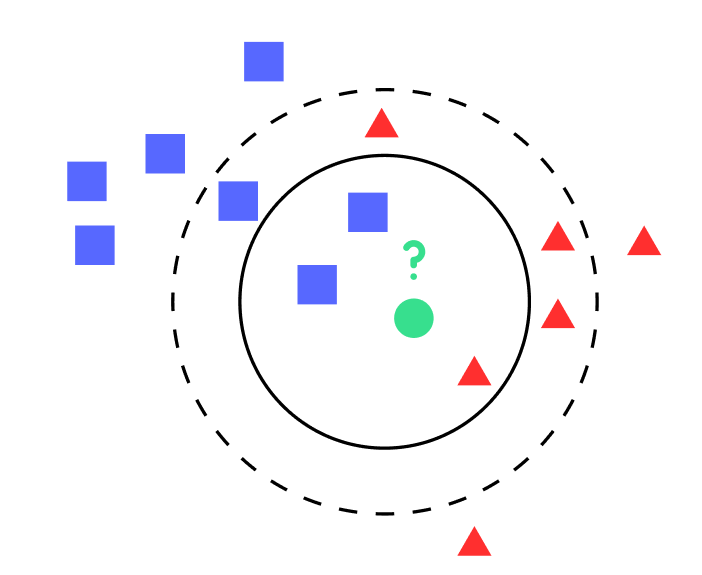
تجد خوارزمية KNN تشابه الميزات باستخدام مقاييس المسافة لتحديد أقرب الجيران لنقطة ما. على سبيل المثال، يمكنها فرز أنواع المشروبات من خلال مقارنتها بأقرب الأنواع إليها، مثل تجميع المشروبات ذات النكهات المتشابهة معاً. الأمر يشبه وجود دليل يساعدك في العثور على المشروبات المتشابهة بناءً على سماتها الأكثر شيوعاً. 🍷
الفكرة وراء KNN مباشرة تماماً:
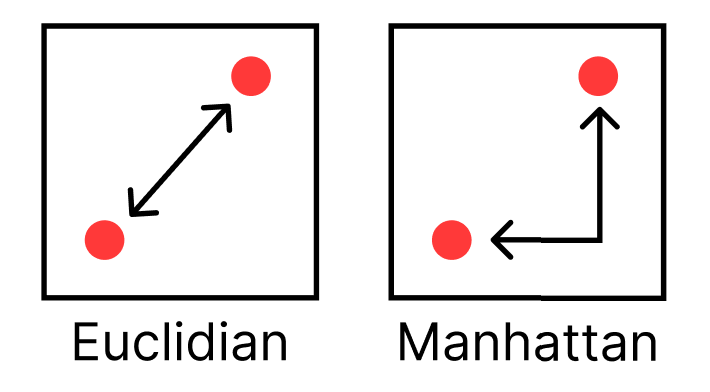
- حساب المسافة: بالنسبة لنقطة اختبار معينة، تقوم الخوارزمية بحساب المسافة بين تلك النقطة وكل نقطة أخرى في مجموعة بيانات التدريب. يمكن حساب المسافة بطرق مختلفة، مثل مسافة إقليدس (Euclidean) أو مسافة مانهاتن (Manhattan).
- العثور على أقرب الجيران: تختار الخوارزمية بعد ذلك نقاط
kفي بيانات التدريب الأقرب إلى نقطة الاختبار.kهو ثابت يحدده المستخدم، ويمكن أن يكون أي عدد صحيح. - إجراء التنبؤ: بالنسبة للتصنيف، تقوم الخوارزمية بتعيين تسمية الفئة الأكثر شيوعاً بين أقرب جيران
kلنقطة الاختبار. بالنسبة للانحدار، تقوم بتعيين متوسط أقرب جيران 'k'.
تُعد KNN خوارزمية تعلم كسول (lazy learning)، مما يعني أنها لا تتعلم نموذجاً بالفعل. بدلاً من ذلك، تقوم بحفظ حالات التدريب واستخدامها للتنبؤ (سيتناول الدرس القادم مرحلة التدريب). وهذا يجعل KNN مكلفة حسابياً خلال مرحلة الاختبار.
على الرغم من بساطتها، يمكن لـ KNN تحقيق أداء جيد بشكل مدهش. ومع ذلك، فهي حساسة لاختيار k ونوع مقياس المسافة، ولا تؤدي بشكل جيد مع البيانات عالية الأبعاد بسبب لعنة الأبعاد (curse of dimensionality).
 اختبر نفسك
يتضمن هذا الدرس اختبارًا قصيرًا. ابدأ الدرس للإجابة عليه وتتبّع تقدمك.
اختبر نفسكيتضمن هذا الدرس اختبارًا قصيرًا. ابدأ الدرس للإجابة عليه وتتبّع تقدمك.
اختبر نفسكيتضمن هذا الدرس اختبارًا قصيرًا. ابدأ الدرس للإجابة عليه وتتبّع تقدمك.

التحدي
سهلفي هذا التحدي، سنتعلم حسابات المسافات المختلفة.
قم بإنشاء دالة باسم distances_option_calculator تستقبل ثلاثة متغيرات: X، و y، و distance_type. ستقوم الدالة بإرجاع المسافة بين X و y بناءً على distance_type.
إليك قائمة بحسابات المسافات الشائعة:
مسافة Euclidian (الأكثر شيوعاً) هي المسافة المستقيمة بين نقطتين. وهي الجذر التربيعي لمجموع مربعات الفروق بين كل إحداثي متناظر للنقاط:
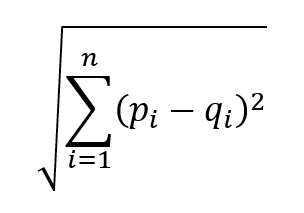
مسافة Manhattan تُعرف أيضاً باسم مسافة Taxicab أو City Block. وهي مجموع الفروق المطلقة بين النقاط عبر جميع الأبعاد. لنقطتين ( P ) و ( Q )، بإحداثيات ( (p_1, p_2, …, p_n) ) و ( (q_1, q_2, …, q_n) ) على التوالي:
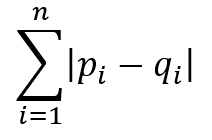
مسافة Hamming: هي عدد المواضع التي تختلف فيها الرموز المتقابلة. غالباً ما تُستخدم للبيانات الفئوية (categorical data).
على سبيل المثال، لنأخذ سلسلتين ثنائيتين (binary strings):
String 1: 1101
String 2: 1001
بمقارنتهما موضعاً بموضع، نرى أن الموضع الثاني يحتوي على بتات مختلفة (1 في String 1 و 0 في String 2). جميع المواضع الأخرى متطابقة. لذا، فإن مسافة Hamming بين هاتين السلسلتين هي 1.
يمكن أن يحتوي distance_type على القيم التالية: hamming، manhattan، euclidian.
جرّب بنفسك
def distances_option_calculator(X, y, distance_type):
    # اكتب الكود هنا
    if distance_type == "euclidian":
        pass
    elif distance_type == "manhattan":
        pass
    elif distance_type == "hamming":
passجميع دروس مقدمة في تعلم الآلة

تدرّب بنفسك: مترجم Python عبر الإنترنت