





مقدمة عن نايف بايز
الدرس 12 من 19 في دورة مقدمة في تعلم الآلة على Coddy.
تعتبر Naive Bayes خوارزمية بسيطة ولكنها قوية تُستخدم لمهام التصنيف في تعلم الآلة.
تعتمد خوارزمية Naive Bayes على نظرية Bayes، التي تخبرنا بكيفية حساب احتمالية وقوع حدث ما (مثل كون البريد الإلكتروني عشوائياً) بناءً على المعرفة المسبقة بالظروف التي قد تكون مرتبطة بالحدث. يأتي الجزء "الساذج" (naive) من افتراض أن جميع الميزات (مثل الكلمات في البريد الإلكتروني) مستقلة عن بعضها البعض، مما يسهل الحسابات. الاستقلال يعني أن وقوع شيء واحد لا يغير فرص وقوع شيء آخر.
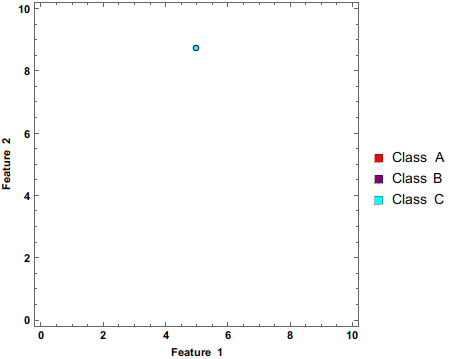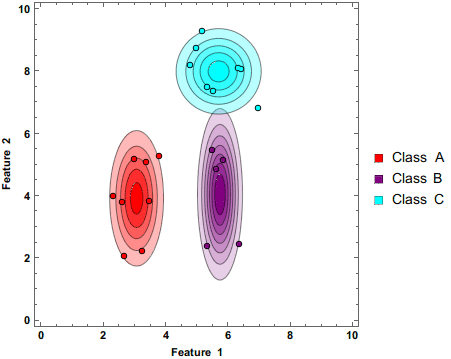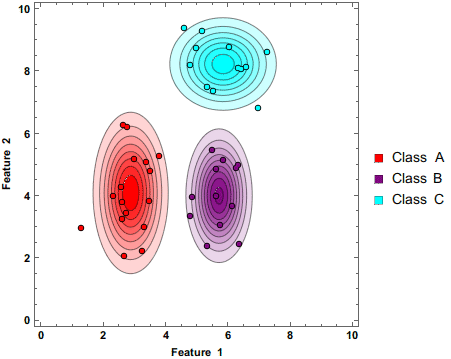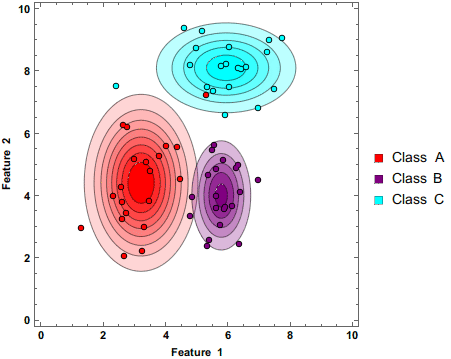
المصدر: ويكيبيديا، مصنف Naive Bayes يقوم بتحديث تقديره أثناء تغذيته بمزيد من البيانات.
إليك كيف يعمل:
- عد التكرارات: أولاً، قم بعدد المرات التي تظهر فيها كل نقطة بيانات في فئات مختلفة. في اكتشاف البريد العشوائي، سنقوم بعدد المرات التي ظهرت فيها كل كلمة في رسائل البريد العشوائي أو غير العشوائي، وفي التشخيص الطبي، قد نقوم بعدد المرات (أو المدة) التي يظهر فيها كل عرض.
- حساب الاحتمالات: بالنسبة لنقطة بيانات جديدة، احسب احتمالية الانتماء إلى كل فئة (ما هي احتمالية أن يكون البريد الإلكتروني الجديد عشوائياً وما هي احتمالية ألا يكون عشوائياً)
- القرار: أخيراً، تجمع الخوارزمية كل هذه الاحتمالات باستخدام نظرية Bayes وتقرر ما إذا كان من المرجح أن يكون البريد الإلكتروني عشوائياً أم لا. كلما زاد الاحتمال، زاد احتمال انتمائه إلى هذه الفئة.
الشيء الرائع في Naive Bayes هو تنفيذه السريع والسهل. إنه يعمل بشكل جيد مع البيانات عالية الأبعاد (مثل النصوص) ويمكنه التعامل مع القيم المفقودة. ومع ذلك، فإن افتراض الاستقلال ليس صحيحاً دائماً في الحياة الواقعية، مما قد يؤدي أحياناً إلى نتائج أقل دقة مقارنة بالخوارزميات الأكثر تعقيداً.
 اختبر نفسك
يتضمن هذا الدرس اختبارًا قصيرًا. ابدأ الدرس للإجابة عليه وتتبّع تقدمك.
اختبر نفسكيتضمن هذا الدرس اختبارًا قصيرًا. ابدأ الدرس للإجابة عليه وتتبّع تقدمك.
اختبر نفسكيتضمن هذا الدرس اختبارًا قصيرًا. ابدأ الدرس للإجابة عليه وتتبّع تقدمك.

التحدي
متوسطفي هذا التحدي، سنتعلم كيفية حساب احتمالية الانتماء إلى فئة معينة. تحتوي مجموعة البيانات play_outside.csv على الأعمدة التالية: temperature, mood, motivation, windy, play. يمثل كل صف نفس الشخص وما إذا كان قد قرر اللعب في الخارج أم لا بناءً على الميزات (temperature, mood, motivation, windy). هدفنا هو التنبؤ بما إذا كان سيذهب للعب في الخارج بناءً على الميزات (temperature, mood, motivation, windy).
إليك مثال على مجموعة بيانات:
| temperature | mood | motivation | windy | play |
| low | good | high | no | yes |
| moderate | good | high | no | yes |
| low | low | medium | yes | no |
قد تبدو المعادلات التالية مخيفة ولكننا سنقوم بتفكيكها.
صيغة Naive Bayes: P(Class|Feature) = P(Feature|Class) * P(Class) / P(Feature)
- P(Feature|Class) - الأرجحية (Likelihood)
- P(Class) - الاحتمال المسبق للفئة (Prior probability of the class)
- P(Feature) - الاحتمال المسبق للمتنبئ (Prior probability of the predictor)
- P(Class|Feature) - بمعنى آخر، ما هو احتمال تصنيف الصف غير المرئي في الفئة
<strong>x</strong>.
لحل هذا، سنحتاج إلى حساب كل مكون من مكونات الصيغة (P(B|Class) * P(Class) / P(B))
- P(Class) - الاحتمال المسبق للفئة
هذا يساوي عدد مرات حدوث كل فئة، مقسوماً على العدد الإجمالي للفئات. على سبيل المثال في مثالنا المكون من 3 صفوف، هناك2/3yes و1/3no.P(yes) = 2/3P(no) = 1/3 - P(Feature|Class) - الأرجحية
هذا يساوي عدد مرات حدوث كل ميزة لفئة معينة. على سبيل المثالP(temperature = <strong>low</strong>|play = <strong>yes</strong>)- هناك صفان حيثplay = yes، وصف واحد حيثtemperature = low(من الصفوف التي يكون فيهاplay = yesفقط)، لذا فإن هذا يساوي1/2. - P(Feature)
هذا يساوي عدد مرات حدوث كل ميزة مقسوماً على العدد الإجمالي للصفوف. على سبيل المثال:p(motivation=high) = 2/3لأن هناك صفين بدوافع عالية مقسومين على العدد الإجمالي للصفوف (3)
التحدي
لقد تم إعطاؤك قاموسين probability_features و probability_target و dataset_name
احسب لكل ميزة (عمود) احتمالية كل سمة.
على سبيل المثال، إليك قيمة probability_target:
probability_target = {
    "yes": 0.66667, # (2/3)
    "no": 0.33333 # (1/3)
}
إليك قيمة probability_features:
probability_features = {
	"temperature": {
		"low": {
			"yes": 0.5, # (1/2)
			"no": 0.5, # (1/2)
		},
		"moderate": {
			"yes": 1, # (1/1)
			"no": 0, # (0/1)
		}
	}
}
ضع في اعتبارك أن أسماء الميزات وأسماء السمات ليست ثابتة. فكل مجموعة بيانات لها ميزات مختلفة وأسماء مختلفة.
أوصي باستخدام مكتبة pandas لتسهيل الحسابات.
جرّب بنفسك
import pandas as pd
probability_features = {}
probability_target = {}
dataset_path = input()
target_variable = input()
df = pd.read_csv(dataset_path)
# اكتب كودك هنا


# -------------------- فرز وطباعة --------------------
# لا تغير أي شيء تحت هذا السطر
sort_features = {q: {k: v for k, v in sorted(a.items() if a != None else {}, key=lambda item: item[0])} for q, a in sorted(probability_features.items(), key=lambda item: item[0])}
sort_target = {k: v for k, v in sorted(probability_target.items(), key=lambda item: item[0])}
print(sort_features)
print(sort_target)جميع دروس مقدمة في تعلم الآلة


تدرّب بنفسك: مترجم Python عبر الإنترنت