





Naive Bayes'e Giriş
Coddy'nin Makine Öğrenmesine Giriş kursunda ders 12 / 19.
Naive Bayes, makine öğreniminde sınıflandırma görevleri için kullanılan basit ama güçlü bir algoritmadır.
Naive Bayes algoritması, bir olayın (bir e-postanın spam olması gibi) olasılığını, olayla ilgili olabilecek koşulların önceden bilinmesine dayanarak nasıl hesaplayacağımızı söyleyen Bayes teoremine dayanır. "Naive" (saf) kısmı, tüm özelliklerin (e-postadaki kelimeler gibi) birbirinden bağımsız olduğu varsayımından gelir ve bu da hesaplamaları basitleştirir. Bağımsız olmak, bir şeyin gerçekleşmesinin başka bir şeyin gerçekleşme olasılığını değiştirmemesi anlamına gelir.
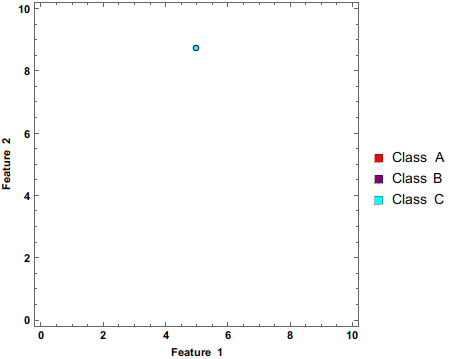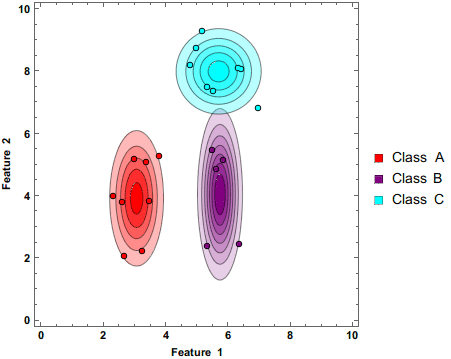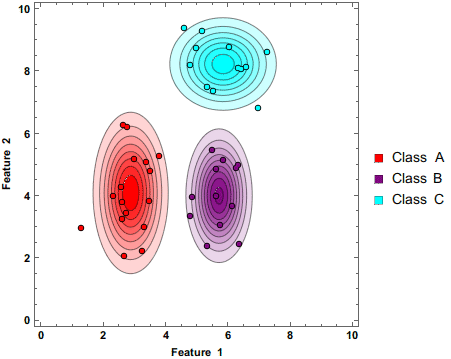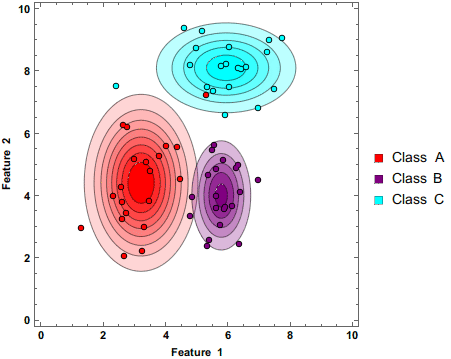
Kaynak: Wikipedia, Daha fazla veri beslendikçe tahminini güncelleyen bir Naive Bayes Sınıflandırıcı.
İşte nasıl çalıştığı:
- Oluşumları Sayın: İlk olarak, her bir veri noktasının farklı sınıflarda kaç kez göründüğünü sayın. E-posta spam tespitinde, her bir kelimenin spam olan veya olmayan e-postalarda kaç kez göründüğünü sayarız; tıbbi teşhiste ise her bir semptomun kaç kez (veya ne kadar süreyle) göründüğünü sayabiliriz.
- Olasılıkları Hesaplayın: Yeni bir veri noktası için her bir sınıfa ait olma olasılığını hesaplayın (yeni bir e-postanın spam olma olasılığı nedir ve spam olmama olasılığı nedir)
- Karar: Son olarak algoritma, Bayes teoremini kullanarak tüm bu olasılıkları birleştirir ve e-postanın spam mi yoksa spam değil mi olma olasılığının daha yüksek olduğuna karar verir. Olasılık ne kadar yüksekse, bu sınıfa ait olma olasılığı o kadar fazladır.
Naive Bayes'in harika yanı, hızlı ve kolay uygulanmasıdır. Yüksek boyutlu verilerle (metin gibi) iyi çalışır ve eksik değerleri işleyebilir. Ancak, bağımsızlık varsayımı gerçek hayatta her zaman doğru değildir ve bu durum bazen daha karmaşık algoritmalara kıyasla daha az doğru sonuçlara yol açabilir.
 Kendini test et
Bu ders kısa bir quiz içerir. Soruları yanıtlamak ve ilerlemeni kaydetmek için derse başla.
Kendini test etBu ders kısa bir quiz içerir. Soruları yanıtlamak ve ilerlemeni kaydetmek için derse başla.
Kendini test etBu ders kısa bir quiz içerir. Soruları yanıtlamak ve ilerlemeni kaydetmek için derse başla.

Görev
OrtaBu meydan okumada, belirli bir sınıfta olma olasılığını nasıl hesaplayacağımızı öğreneceğiz. play_outside.csv veri seti şu sütunları içerir: temperature, mood, motivation, windy, play. Her satır aynı kişiyi ve özelliklere (temperature, mood, motivation, windy) dayanarak dışarıda oynayıp oynamamaya karar verip vermediğini temsil eder. Amacımız, özelliklere (temperature, mood, motivation, windy) dayanarak dışarıda oynayıp oynamayacağını tahmin etmektir.
İşte bir veri seti örneği:
| temperature | mood | motivation | windy | play |
| low | good | high | no | yes |
| moderate | good | high | no | yes |
| low | low | medium | yes | no |
Aşağıdaki denklemler korkutucu görünebilir ama onları parçalara ayıracağız.
Naive Bayes formülü: P(Class|Feature) = P(Feature|Class) * P(Class) / P(Feature)
- P(Feature|Class) - Olabilirlik (Likelihood)
- P(Class) - Sınıfın önsel olasılığı (Prior probability)
- P(Feature) - Tahmin edicinin önsel olasılığı
- P(Class|Feature) - Başka bir deyişle, görülmemiş bir satırın
<strong>x</strong>sınıfına sınıflandırılma olasılığı nedir?
Bunu çözmek için formülün her bir bileşenini hesaplamamız gerekecek (P(B|Class) * P(Class) / P(B))
- P(Class) - Sınıfın önsel olasılığı
Bu, her bir sınıfın oluşma sayısının toplam sınıf sayısına bölünmesine eşittir. Örneğin 3 satırlık örneğimizde,2/3yes ve1/3no vardır.P(yes) = 2/3P(no) = 1/3 - P(Feature|Class) - Olabilirlik (Likelihood)
Bu, belirli bir sınıfın her bir özelliğinin oluşma sayısına eşittir. ÖrneğinP(temperature = <strong>low</strong>|play = <strong>yes</strong>)-play = yesolan iki satır vetemperature = lowolan (yalnızcaplay = yesolan satırlar arasında) bir satır vardır, dolayısıyla bu1/2'ye eşittir. - P(Feature)
Bu, her bir özelliğin oluşma sayısının toplam satır sayısına bölünmesine eşittir. Örneğin:p(motivation=high) = 2/3çünkü yüksek motivasyona sahip iki satır vardır ve bu toplam satır sayısına (3) bölünür.
Meydan Okuma
Size probability_features, probability_target adında iki sözlük ve dataset_name verilmiştir.
Her bir özellik (sütun) için her bir özniteliğin olasılığını hesaplayın.
Örneğin probability_target değeri şöyledir:
probability_target = {
    "yes": 0.66667, # (2/3)
    "no": 0.33333 # (1/3)
}
İşte probability_features değeri:
probability_features = {
	"temperature": {
		"low": {
			"yes": 0.5, # (1/2)
			"no": 0.5, # (1/2)
		},
		"moderate": {
			"yes": 1, # (1/1)
			"no": 0, # (0/1)
		}
	}
}
Özellik adlarının ve öznitelik adlarının sabit olmadığını unutmayın. Her veri setinin farklı özellikleri ve farklı adları vardır.
Hesaplamaları kolaylaştırmak için pandas modülünü kullanmanızı öneririm.
Kendin dene
import pandas as pd
probability_features = {}
probability_target = {}
dataset_path = input()
target_variable = input()
df = pd.read_csv(dataset_path)
# Kodunuzu buraya yazın


# -------------------- Sırala ve yazdır --------------------
# Bu satırın altını değiştirmeyin
sort_features = {q: {k: v for k, v in sorted(a.items() if a != None else {}, key=lambda item: item[0])} for q, a in sorted(probability_features.items(), key=lambda item: item[0])}
sort_target = {k: v for k, v in sorted(probability_target.items(), key=lambda item: item[0])}
print(sort_features)
print(sort_target)Makine Öğrenmesine Giriş bölümündeki tüm dersler


Kendi başına pratik yap: Online Python derleyicisi