





K-Means 简介
Coddy 机器学习入门 课程的第 9 课,共 19 课。
K-means 是最简单、应用最广泛的聚类算法之一。它的目标是将 n 个观测值划分为 k 个簇,使每个观测值都属于均值(质心)最近的簇。质心可以作为簇的原型。假设你有一堆不同的水果,想按种类把它们分到不同的篮子里,但你没有标签。K-means 可以帮你做到这一点,只不过它处理的是数据点,而不是水果!
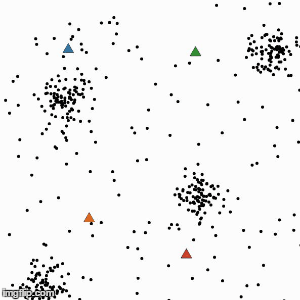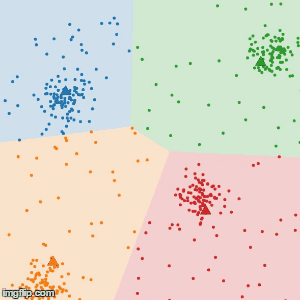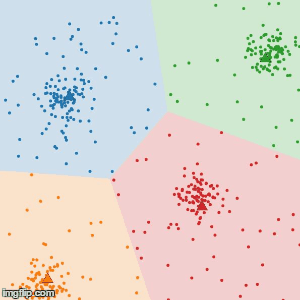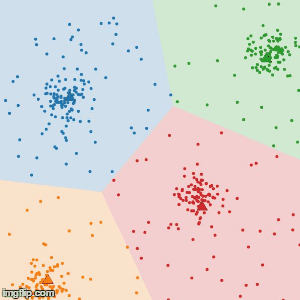
Incheol,CC BY-SA 4.0,来自 Wikimedia Commons
K-means 如何工作?
该算法通过简单高效的迭代过程,将数据集划分为 k 个簇。
- 初始化质心:首先,从数据集中选择
k个点作为初始质心。这些点可以随机选择,也可以根据特定策略选择。 - 分配簇:对于数据集中的每个点,找到距离它最近的质心(使用欧几里得距离等距离度量),并将该点分配到对应的簇中。
- 更新质心:将所有点分配到簇后,计算每个簇中所有点的均值,以重新计算质心。
- 重复步骤 2 和 3:重复以上步骤,直到质心不再发生明显变化。这表示算法已经收敛,簇也趋于稳定。
 自我测试
这节课包含一个小测验。开始学习即可作答,并记录你的进度。
自我测试这节课包含一个小测验。开始学习即可作答,并记录你的进度。
自我测试这节课包含一个小测验。开始学习即可作答,并记录你的进度。

挑战
简单确定最佳聚类数量 k 是关键的一步。有多种方法可以做到这一点,其中肘部法是最常用的方法之一。
这种方法需要持续运行 K-means,让 k 从 k=1 迭代到 k=n。对于每个 k 值,我们都会计算簇内平方和(WCSS)。
每个簇都有一个质心,WCSS 是所有点到质心的距离的平方和。
创建一个名为 wcss 的函数,接收一个数据点列表(这些点属于同一个簇),并返回该簇的 WCSS。请按以下步骤操作:
找到质心。质心是表示簇中所有点平均位置的点:
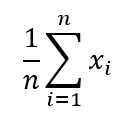
例如,下面是两个 3D 点组成的列表:(1, 2 ,3), (4, 5, 6)。质心是:(1 + 4) / 2 = 2.5, (2 + 5) / 2 = 3.5, (3 + 6) / 2 = 4.5, >> (2.5, 3.5, 4.5)- 计算每个点到质心的欧几里得距离
- 返回所有距离的总和除以点的数量
亲手试试
def euclidian_distance(point_a, point_b):
    return (sum([(point_a[i] - point_b[i])**2 for i in range(len(point_a))]))**0.5

def wcss(points):
# 在这里编写代码机器学习入门中的所有课

自己练习: Python 在线编译器