





KNN 简介
Coddy 机器学习入门 课程的第 6 课,共 19 课。
K-Nearest Neighbors(KNN)是一种监督学习算法,可用于分类和回归问题。它简单而强大,常被用作更复杂模型的基线。
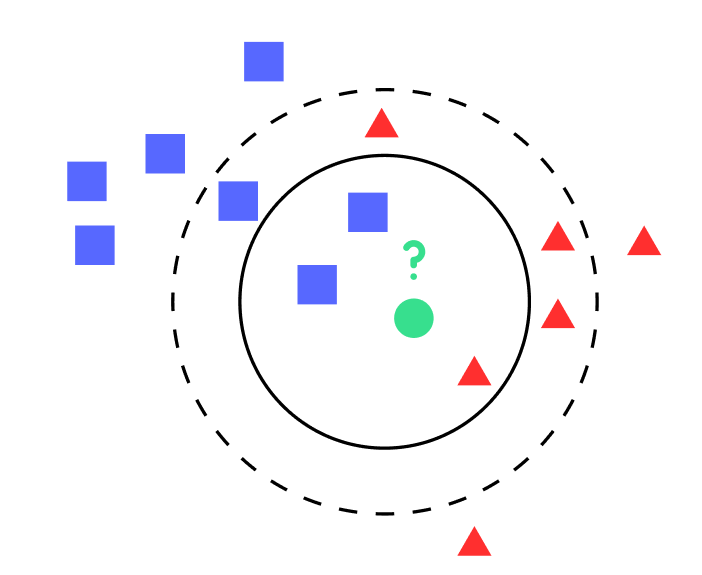
KNN 算法使用距离度量来寻找特征之间的相似性,从而确定距离某个点最近的邻居。例如,它可以通过与附近的葡萄酒进行比较来为葡萄酒分类,比如把口味相似的葡萄酒归为一组。就像有一位向导,能根据葡萄酒最常见的特征,帮你找出哪些葡萄酒彼此相似。🍷
KNN 背后的思路非常直观:
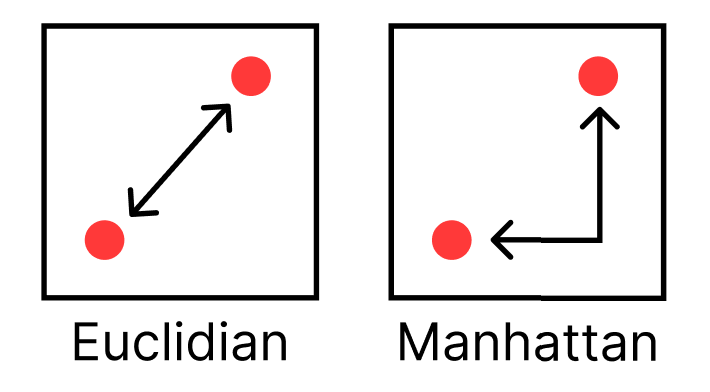
- 计算距离:对于给定的测试点,算法会计算该点与训练数据集中的其他每个点之间的距离。距离可以通过多种方式计算,例如欧几里得距离或曼哈顿距离。
- 寻找最近邻居:然后,算法会从训练数据中选出距离测试点最近的
k个点。k是由用户定义的常量,可以是任意整数。 - 进行预测:对于分类,算法会将
k个最近邻居中最常见的类别标签分配给测试点。对于回归,算法会将最近的 ‘k’ 个邻居的平均值分配给测试点。
KNN 是一种惰性学习算法,这意味着它实际上不会学习模型,而是记住训练实例,并在预测时使用它们(下一课将介绍训练阶段)。因此,KNN 在测试阶段的计算开销很大。
尽管 KNN 很简单,但它的表现可能出奇地好。不过,它对 k 的取值和距离度量的类型很敏感,而且由于维度灾难,它在高维数据上的表现不佳。
 自我测试
这节课包含一个小测验。开始学习即可作答,并记录你的进度。
自我测试这节课包含一个小测验。开始学习即可作答,并记录你的进度。
自我测试这节课包含一个小测验。开始学习即可作答,并记录你的进度。

挑战
简单在这个挑战中,我们将学习不同的距离计算方法。
创建一个名为 distances_option_calculator 的函数,它接收三个变量:X、y 和 distance_type。该函数会根据 distance_type 返回 X 和 y 之间的距离。
以下是一些常见的距离计算方法:
欧几里得距离(最常见):两点之间的直线距离。它等于各点对应坐标之差的平方和的平方根:
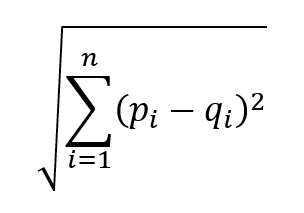
曼哈顿距离也称为出租车距离或城市街区距离。它是所有维度上各点之间差值的绝对值之和。对于坐标分别为 ( (p_1, p_2, …, p_n) ) 和 ( (q_1, q_2, …, q_n) ) 的两点 ( P ) 和 ( Q ):
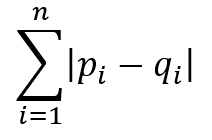
汉明距离:对应符号不同的位置数量。它常用于分类数据。
例如,来看两个二进制字符串:
String 1: 1101
String 2: 1001
逐个位置比较它们,可以看到第二个位置的位不同(String 1 中是 1,String 2 中是 0)。其他位置都相同。因此,这两个字符串之间的汉明距离是 1。
distance_type 可以取以下值:hamming、manhattan、euclidian。
亲手试试
def distances_option_calculator(X, y, distance_type):
    # 在这里编写代码
    if distance_type == "euclidian":
        pass
    elif distance_type == "manhattan":
        pass
    elif distance_type == "hamming":
pass机器学习入门中的所有课

自己练习: Python 在线编译器