





朴素贝叶斯简介
Coddy 机器学习入门 课程的第 12 课,共 19 课。
朴素贝叶斯是一种简单而强大的算法,可用于机器学习中的分类任务。
朴素贝叶斯算法基于贝叶斯定理,它告诉我们如何根据与某个事件可能相关的条件的先验知识,计算该事件发生的概率(例如一封邮件是垃圾邮件的概率)。“朴素”一词源于这样的假设:所有特征(例如邮件中的词语)彼此独立,这简化了计算。彼此独立意味着一件事的发生不会改变另一件事发生的可能性。
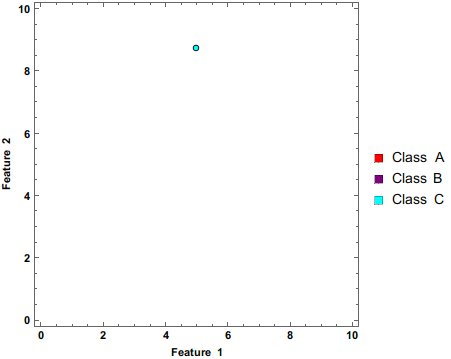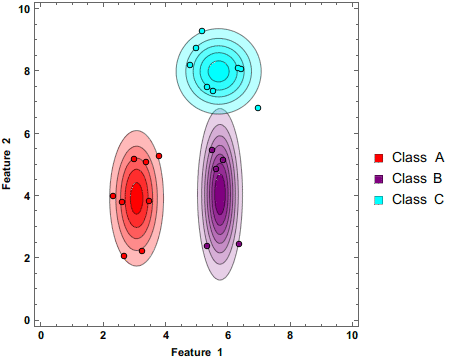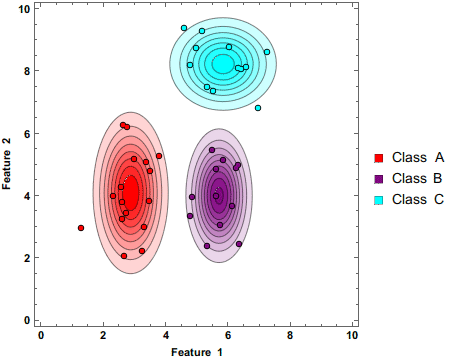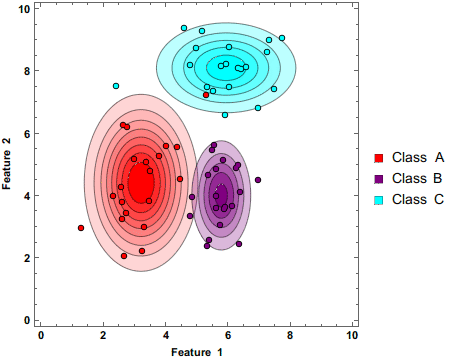
来源:维基百科,一个朴素贝叶斯分类器在不断接收更多数据时更新其估算。
它的工作原理如下:
- 统计出现次数:首先,统计每个数据点在不同类别中出现的次数。在检测垃圾邮件时,我们会统计每个词在垃圾邮件和非垃圾邮件中出现的次数;在医疗诊断中,我们可能会统计每种症状出现的次数(或持续时间)。
- 计算概率:对于新的数据点,计算它属于每个类别的概率(新邮件是垃圾邮件的概率,以及它不是垃圾邮件的概率)。
- 做出判断:最后,算法使用贝叶斯定理综合所有这些概率,并判断这封邮件更可能是垃圾邮件还是非垃圾邮件。概率越高,它就越可能属于该类别。
朴素贝叶斯的优点是实现起来快速而简单。它适用于高维数据(例如文本),也能处理缺失值。不过,独立性假设在现实生活中并不总是成立,因此与更复杂的算法相比,有时会导致结果不够准确。
 自我测试
这节课包含一个小测验。开始学习即可作答,并记录你的进度。
自我测试这节课包含一个小测验。开始学习即可作答,并记录你的进度。
自我测试这节课包含一个小测验。开始学习即可作答,并记录你的进度。

挑战
中等在这个挑战中,我们将学习如何计算属于某个特定类别的概率。数据集 play_outside.csv 包含以下列:temperature, mood, motivation, windy, play。每一行代表同一个人,以及他是否根据特征(temperature, mood, motivation, windy)决定到户外玩。我们的目标是根据特征(temperature, mood, motivation, windy)预测他是否会到户外玩。
下面是一个数据集示例:
| temperature | mood | motivation | windy | play |
| low | good | high | no | yes |
| moderate | good | high | no | yes |
| low | low | medium | yes | no |
下面的公式看起来可能有些难懂,不过我们会逐步讲解。
朴素贝叶斯公式:P(Class|Feature) = P(Feature|Class) * P(Class) / P(Feature)
- P(Feature|Class) -似然
- P(Class) - 类别的先验概率
- P(Feature) - 预测变量的先验概率
- P(Class|Feature) - 换句话说,未见过的行被分类到类别
<strong>x</strong>的概率是多少?
要解决这个问题,我们需要计算公式中的每个组成部分(P(B|Class) * P(Class) / P(B))
- P(Class) - 类别的先验概率
它等于每个类别出现的次数除以类别总数。例如,在我们的 3 行示例中,2/3是 yes,1/3是 no。P(yes) = 2/3P(no) = 1/3 - P(Feature|Class) -似然
它等于给定类别的每个特征出现的次数。例如:P(temperature = <strong>low</strong>|play = <strong>yes</strong>):有两行满足play = yes,其中只有一行的temperature = low,所以结果是1/2。 - P(Feature)
它等于每个特征出现的次数除以总行数。例如:p(motivation=high) = 2/3,因为有两行的 motivation 是 high,除以总行数(3)后,结果为2/3。
挑战
你会获得两个字典 probability_features、probability_target,以及 dataset_name
计算每个特征(列)中每个属性的概率。
例如,下面是 probability_target 的值:
probability_target = {
    "yes": 0.66667, # (2/3)
    "no": 0.33333 # (1/3)
}
下面是 probability_features 的值:
probability_features = {
	"temperature": {
		"low": {
			"yes": 0.5, # (1/2)
			"no": 0.5, # (1/2)
		},
		"moderate": {
			"yes": 1, # (1/1)
			"no": 0, # (0/1)
		}
	}
}
请记住,特征名称和属性名称不是固定的。每个数据集都有不同的特征和名称。
我建议使用 pandas 模块来简化计算。
亲手试试
import pandas as pd
probability_features = {}
probability_target = {}
dataset_path = input()
target_variable = input()
df = pd.read_csv(dataset_path)
# 在这里编写你的代码


# -------------------- 排序并打印 --------------------
# 不要修改这行以下的代码
sort_features = {q: {k: v for k, v in sorted(a.items() if a != None else {}, key=lambda item: item[0])} for q, a in sorted(probability_features.items(), key=lambda item: item[0])}
sort_target = {k: v for k, v in sorted(probability_target.items(), key=lambda item: item[0])}
print(sort_features)
print(sort_target)机器学习入门中的所有课


自己练习: Python 在线编译器