








Pengantar K-Means
Pelajaran 9 dari 19 dalam kursus Pengantar Machine Learning di Coddy.
K-means adalah salah satu algoritma pengelompokan yang paling sederhana dan paling banyak digunakan. Algoritma ini bertujuan membagi n pengamatan menjadi k kelompok, dengan setiap pengamatan berada dalam kelompok yang memiliki nilai rata-rata (centroid) terdekat, yang berfungsi sebagai prototipe kelompok tersebut. Misalnya, kamu memiliki beragam buah dan ingin mengelompokkannya ke dalam keranjang berdasarkan jenisnya, tetapi kamu tidak memiliki labelnya. K-means membantumu melakukan hal itu, tetapi menggunakan titik data, bukan buah!
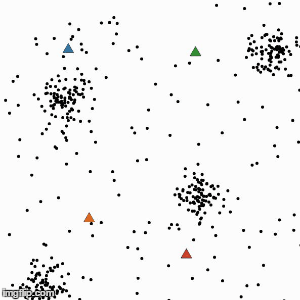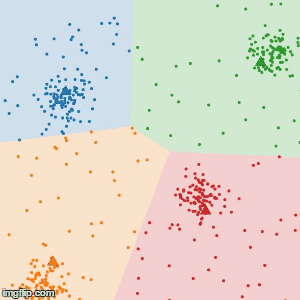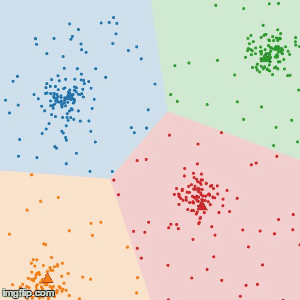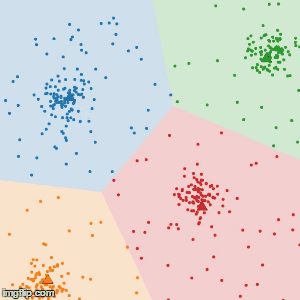
Incheol, CC BY-SA 4.0, melalui Wikimedia Commons
Bagaimana Cara Kerja K-Means?
Algoritma ini mengikuti prosedur iteratif yang sederhana dan efisien untuk membagi kumpulan data menjadi k kelompok.
- Inisialisasi Centroid: Pertama, pilih
ktitik dari kumpulan data sebagai centroid awal. Titik-titik ini dapat dipilih secara acak atau berdasarkan strategi tertentu. - Tetapkan Kelompok: Untuk setiap titik dalam kumpulan data, cari centroid terdekat (menggunakan ukuran jarak seperti jarak Euclidean), lalu tetapkan titik tersebut ke kelompok itu.
- Perbarui Centroid: Setelah semua titik ditetapkan ke kelompok, hitung ulang centroid dengan mengambil nilai rata-rata semua titik dalam setiap kelompok.
- Ulangi Langkah 2 dan 3: Langkah-langkah di atas diulangi sampai centroid tidak lagi berubah secara signifikan. Artinya, algoritma telah konvergen dan kelompok-kelompoknya stabil.
 Uji dirimu
Pelajaran ini berisi kuis singkat. Mulai pelajarannya untuk menjawab kuis dan melacak progresmu.
Uji dirimuPelajaran ini berisi kuis singkat. Mulai pelajarannya untuk menjawab kuis dan melacak progresmu.
Uji dirimuPelajaran ini berisi kuis singkat. Mulai pelajarannya untuk menjawab kuis dan melacak progresmu.

Tantangan
MudahMenentukan jumlah cluster yang optimal, k, adalah langkah penting. Ada berbagai metode untuk melakukannya, dan Elbow Method adalah salah satu yang paling populer.
Teknik ini melibatkan menjalankan K-means berulang kali untuk k=1 hingga k=n. Untuk setiap nilai k, kita menghitung nilai jumlah kuadrat dalam cluster (WCSS).
Setiap cluster memiliki centroid, dan WCSS adalah jumlah semua jarak dari centroid yang dikuadratkan.
Buat fungsi bernama wcss yang menerima list titik data (dari cluster yang sama) dan mengembalikan WCSS cluster. Ikuti langkah-langkah berikut:
Temukan centroid. Centroid adalah titik yang mewakili posisi rata-rata semua titik dalam sebuah cluster:
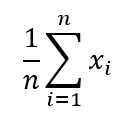
Contohnya, berikut list dua titik 3D:(1, 2 ,3), (4, 5, 6). Centroid-nya adalah:(1 + 4) / 2 = 2.5, (2 + 5) / 2 = 3.5, (3 + 6) / 2 = 4.5, >> (2.5, 3.5, 4.5)- Hitung jarak Euclidean antara setiap titik dan centroid
- Kembalikan jumlah semua jarak dibagi dengan jumlah titik
Coba sendiri
def euclidian_distance(point_a, point_b):
    return (sum([(point_a[i] - point_b[i])**2 for i in range(len(point_a))]))**0.5

def wcss(points):
# Tulis kodemu di siniSemua pelajaran di Pengantar Machine Learning

Latihan sendiri: Compiler Python online