








Pengantar Naive Bayes
Pelajaran 12 dari 19 dalam kursus Pengantar Machine Learning di Coddy.
Naive Bayes adalah algoritma sederhana tetapi andal yang digunakan untuk tugas klasifikasi dalam machine learning.
Algoritma Naive Bayes didasarkan pada teorema Bayes, yang menjelaskan cara menghitung probabilitas suatu kejadian, seperti email yang merupakan spam, berdasarkan pengetahuan sebelumnya tentang kondisi yang mungkin berkaitan dengan kejadian tersebut. Bagian "naive" berasal dari asumsi bahwa semua fitur, seperti kata-kata dalam email, saling independen, sehingga perhitungannya lebih sederhana. Independen berarti terjadinya satu hal tidak mengubah kemungkinan terjadinya hal lain.
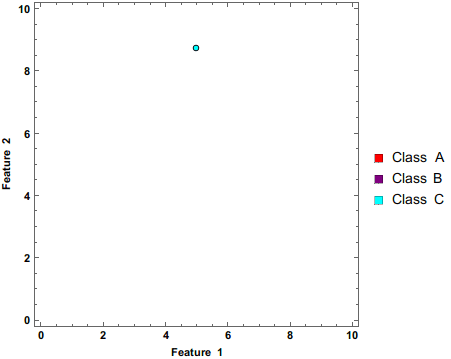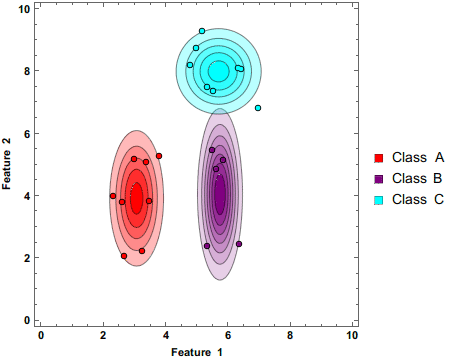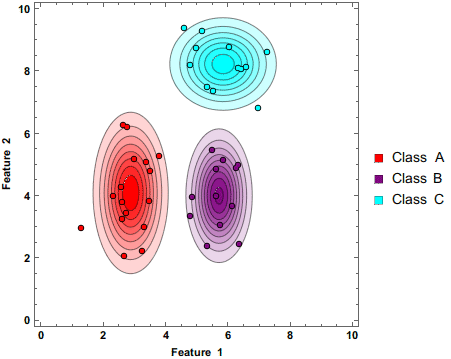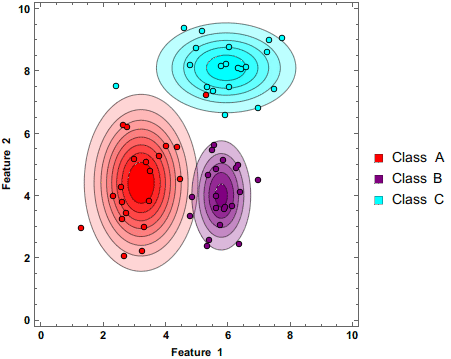
Sumber: Wikipedia, classifier Naive Bayes yang memperbarui perkiraannya saat semakin banyak data diberikan.
Begini cara kerjanya:
- Hitung Kemunculan: Pertama, hitung berapa kali setiap titik data muncul di berbagai class. Dalam deteksi spam email, kita akan menghitung berapa kali setiap kata muncul di email spam atau bukan spam. Dalam diagnosis medis, kita dapat menghitung berapa kali atau berapa lama setiap gejala muncul.
- Hitung Probabilitas: Untuk titik data baru, hitung probabilitasnya termasuk ke setiap class (berapa probabilitas email baru merupakan spam dan berapa probabilitasnya bukan spam)
- Keputusan: Terakhir, algoritma menggabungkan semua probabilitas ini menggunakan teorema Bayes dan memutuskan apakah email lebih mungkin merupakan spam atau bukan spam. Semakin tinggi probabilitasnya, semakin besar kemungkinan email itu termasuk ke class tersebut.
Hal menarik tentang Naive Bayes adalah implementasinya cepat dan mudah. Algoritma ini bekerja dengan baik pada data berdimensi tinggi, seperti teks, dan dapat menangani nilai yang hilang. Namun, asumsi independensi tidak selalu benar dalam kehidupan nyata, sehingga terkadang hasilnya kurang akurat dibandingkan algoritma yang lebih kompleks.
 Uji dirimu
Pelajaran ini berisi kuis singkat. Mulai pelajarannya untuk menjawab kuis dan melacak progresmu.
Uji dirimuPelajaran ini berisi kuis singkat. Mulai pelajarannya untuk menjawab kuis dan melacak progresmu.
Uji dirimuPelajaran ini berisi kuis singkat. Mulai pelajarannya untuk menjawab kuis dan melacak progresmu.

Tantangan
SedangDalam tantangan ini, kita akan belajar menghitung probabilitas suatu baris termasuk dalam kelas tertentu. Dataset play_outside.csv berisi kolom-kolom berikut: temperature, mood, motivation, windy, play. Setiap baris mewakili orang yang sama dan menunjukkan apakah ia memutuskan untuk bermain di luar atau tidak berdasarkan fitur (temperature, mood, motivation, windy). Tujuan kita adalah memprediksi apakah ia akan bermain di luar berdasarkan fitur (temperature, mood, motivation, windy).
Berikut contoh dataset:
| temperature | mood | motivation | windy | play |
| low | good | high | no | yes |
| moderate | good | high | no | yes |
| low | low | medium | yes | no |
Persamaan berikut mungkin tampak rumit, tetapi kita akan menguraikannya.
Rumus Naive Bayes: P(Class|Feature) = P(Feature|Class) * P(Class) / P(Feature)
- P(Feature|Class) -Kemungkinan
- P(Class) - Probabilitas awal kelas
- P(Feature) - Probabilitas awal prediktor
- P(Class|Feature) - Dengan kata lain, berapa probabilitas baris yang belum diketahui akan diklasifikasikan ke kelas
<strong>x</strong>.
Untuk menyelesaikannya, kita perlu menghitung setiap komponen rumus (P(B|Class) * P(Class) / P(B))
- P(Class) - Probabilitas awal kelas
Nilai ini sama dengan jumlah kemunculan setiap kelas dibagi jumlah total kelas. Misalnya, dalam contoh kita yang terdiri dari 3 baris, ada2/3yes dan1/3no.P(yes) = 2/3P(no) = 1/3 - P(Feature|Class) -Kemungkinan
Nilai ini sama dengan jumlah kemunculan setiap fitur untuk kelas tertentu. ContohnyaP(temperature = <strong>low</strong>|play = <strong>yes</strong>)- Ada dua baris denganplay = yes, dan satu baris dengantemperature = low(hanya dari baris denganplay = yes), jadi nilainya adalah1/2. - P(Feature)
Nilai ini sama dengan jumlah kemunculan setiap fitur dibagi jumlah total baris. Contohnya:p(motivation=high) = 2/3karena ada dua baris dengan motivasi tinggi, dibagi jumlah total baris (3)
Tantangan
Kamu diberi dua dictionary probability_features, probability_target, dan dataset_name
Hitung probabilitas setiap atribut untuk setiap fitur (kolom).
Berikut contoh nilai probability_target:
probability_target = {
    "yes": 0.66667, # (2/3)
    "no": 0.33333 # (1/3)
}
Berikut nilai probability_features:
probability_features = {
	"temperature": {
		"low": {
			"yes": 0.5, # (1/2)
			"no": 0.5, # (1/2)
		},
		"moderate": {
			"yes": 1, # (1/1)
			"no": 0, # (0/1)
		}
	}
}
Ingat, nama fitur dan nama atribut tidak tetap. Setiap dataset memiliki fitur dan nama yang berbeda.
Sebaiknya gunakan module pandas agar perhitungannya lebih mudah.
Coba sendiri
import pandas as pd
probability_features = {}
probability_target = {}
dataset_path = input()
target_variable = input()
df = pd.read_csv(dataset_path)
# Tulis kodemu di sini


# -------------------- Urutkan dan cetak --------------------
# Jangan ubah bagian di bawah baris ini
sort_features = {q: {k: v for k, v in sorted(a.items() if a != None else {}, key=lambda item: item[0])} for q, a in sorted(probability_features.items(), key=lambda item: item[0])}
sort_target = {k: v for k, v in sorted(probability_target.items(), key=lambda item: item[0])}
print(sort_features)
print(sort_target)Semua pelajaran di Pengantar Machine Learning


Latihan sendiri: Compiler Python online