








Pengantar KNN
Pelajaran 6 dari 19 dalam kursus Pengantar Machine Learning di Coddy.
K-Nearest Neighbors (KNN) adalah algoritma pembelajaran terawasi yang digunakan untuk masalah klasifikasi dan regresi. Algoritma ini sederhana tetapi ampuh, dan sering digunakan sebagai model dasar untuk model yang lebih kompleks.
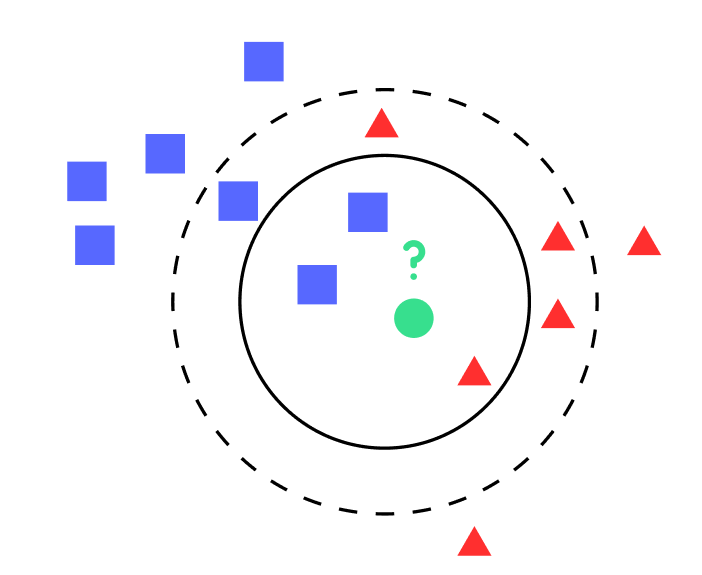
Algoritma KNN menemukan kemiripan fitur menggunakan metrik jarak untuk mengidentifikasi tetangga terdekat dari suatu titik. Misalnya, algoritma ini dapat mengelompokkan wine dengan membandingkannya dengan wine terdekat, seperti mengelompokkan wine yang memiliki rasa serupa. Ibarat memiliki pemandu yang membantumu menemukan wine yang mirip berdasarkan karakteristiknya yang paling umum. 🍷
Gagasan di balik KNN cukup sederhana:
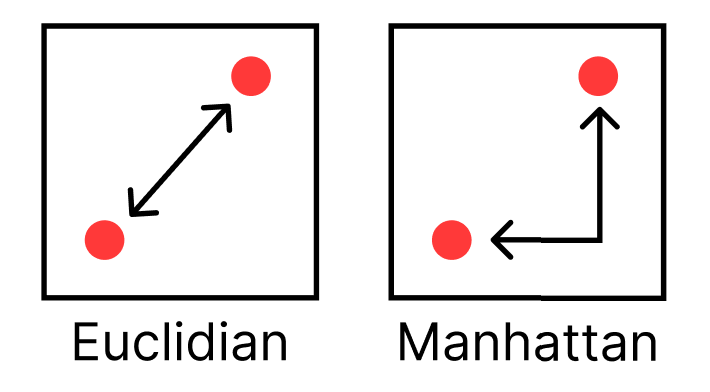
- Menghitung Jarak: Untuk suatu titik uji, algoritma menghitung jarak antara titik tersebut dan setiap titik lain dalam dataset pelatihan. Jarak dapat dihitung dengan berbagai cara, seperti jarak Euclidean atau Manhattan.
- Menemukan Tetangga Terdekat: Algoritma kemudian memilih
ktitik dalam data pelatihan yang paling dekat dengan titik uji.kadalah konstanta yang ditentukan pengguna dan dapat berupa bilangan bulat apa pun. - Membuat Prediksi: Untuk klasifikasi, algoritma menetapkan label kelas yang paling umum di antara
ktetangga terdekat sebagai label titik uji. Untuk regresi, algoritma menetapkan nilai rata-rata dari ‘k’ tetangga terdekat.
KNN adalah algoritma pembelajaran malas, yang berarti algoritma ini tidak benar-benar mempelajari sebuah model. Sebaliknya, algoritma ini mengingat instance pelatihan dan menggunakannya untuk membuat prediksi (pelajaran berikutnya akan membahas tahap pelatihan). Hal ini membuat KNN membutuhkan banyak komputasi selama tahap pengujian.
Meskipun sederhana, KNN dapat memberikan kinerja yang sangat baik. Namun, algoritma ini sensitif terhadap pilihan k dan jenis metrik jarak, serta tidak bekerja dengan baik pada data berdimensi tinggi karena kutukan dimensionalitas.
 Uji dirimu
Pelajaran ini berisi kuis singkat. Mulai pelajarannya untuk menjawab kuis dan melacak progresmu.
Uji dirimuPelajaran ini berisi kuis singkat. Mulai pelajarannya untuk menjawab kuis dan melacak progresmu.
Uji dirimuPelajaran ini berisi kuis singkat. Mulai pelajarannya untuk menjawab kuis dan melacak progresmu.

Tantangan
MudahDalam tantangan ini, kita akan mempelajari berbagai perhitungan jarak.
Buat fungsi bernama distances_option_calculator yang menerima tiga variabel: X, y, dan distance_type. Fungsi ini akan mengembalikan jarak antara X dan y sesuai dengan distance_type.
Berikut beberapa perhitungan jarak yang umum:
Jarak Euclidian (paling umum) adalah jarak garis lurus antara dua titik. Jarak ini merupakan akar kuadrat dari jumlah kuadrat selisih antara setiap koordinat yang bersesuaian dari kedua titik:
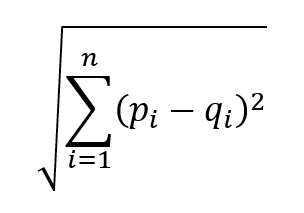
Jarak Manhattan juga dikenal sebagai jarak Taxicab atau City Block. Jarak ini merupakan jumlah selisih absolut antara titik-titik di semua dimensi. Untuk dua titik ( P ) dan ( Q ), dengan koordinat ( (p_1, p_2, …, p_n) ) dan ( (q_1, q_2, …, q_n) ) secara berurutan:
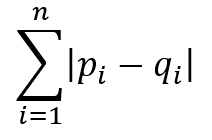
Jarak Hamming: Jumlah posisi yang simbol-simbolnya berbeda. Jarak ini sering digunakan untuk data kategorikal.
Sebagai contoh, kita ambil dua string biner:
String 1: 1101
String 2: 1001
Dengan membandingkannya posisi demi posisi, kita melihat bahwa bit pada posisi kedua berbeda (1 pada String 1 dan 0 pada String 2). Semua posisi lainnya sama. Jadi, jarak Hamming antara kedua string ini adalah 1.
distance_type dapat memiliki nilai berikut: hamming, manhattan, euclidian.
Coba sendiri
def distances_option_calculator(X, y, distance_type):
    # Tulis kodemu di sini
    if distance_type == "euclidian":
        pass
    elif distance_type == "manhattan":
        pass
    elif distance_type == "hamming":
passSemua pelajaran di Pengantar Machine Learning

Latihan sendiri: Compiler Python online