





Введение в наивный байесовский классификатор
Урок 12 из 19 курса Введение в машинное обучение на Coddy.
Наивный Байес — это простой, но мощный алгоритм, используемый для задач классификации в машинном обучении.
Алгоритм Наивного Байеса основан на теореме Байеса, которая говорит нам, как рассчитать вероятность события (например, того, что электронное письмо является спамом) на основе априорных знаний об условиях, которые могут быть связаны с этим событием. «Наивная» часть происходит из предположения, что все признаки (например, слова в электронном письме) независимы друг от друга, что упрощает вычисления. Быть независимым означает, что наступление одного события не меняет шансы наступления другого.
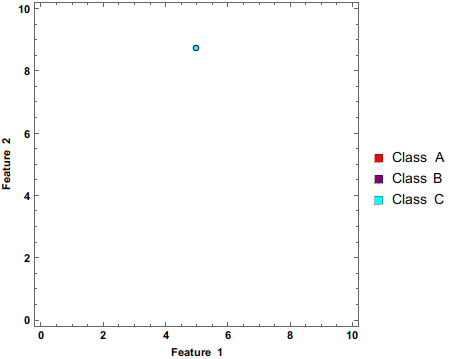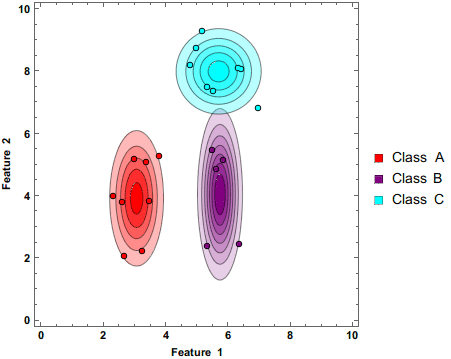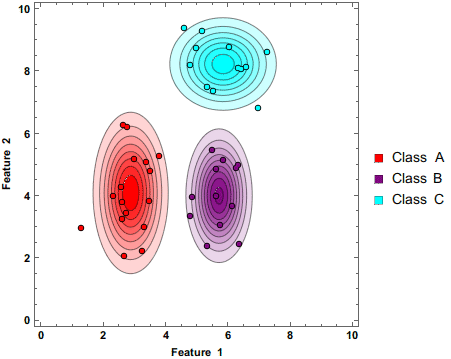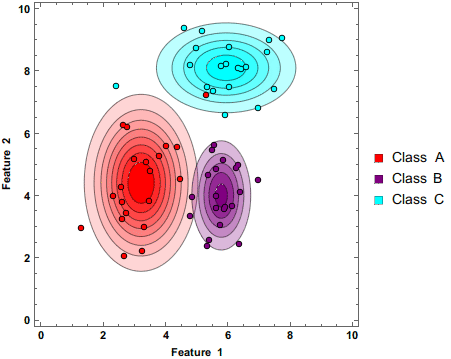
Источник: Википедия, Классификатор Наивного Байеса, обновляющий свою оценку по мере поступления новых данных.
Вот как это работает:
- Подсчет вхождений: Сначала подсчитайте, сколько раз каждая точка данных появляется в разных классах. При обнаружении спама в электронной почте мы будем считать, сколько раз каждое слово появлялось в спам-письмах или обычных письмах, а в медицинской диагностике мы можем считать, сколько раз (или как долго) проявляется каждый симптом.
- Вычисление вероятностей: Для новой точки данных вычислите вероятность принадлежности к каждому классу (какова вероятность того, что новое электронное письмо является спамом, и какова вероятность того, что оно не является спамом)
- Решение: Наконец, алгоритм объединяет все эти вероятности с помощью теоремы Байеса и решает, является ли электронное письмо с большей вероятностью спамом или нет. Чем выше вероятность, тем больше вероятность того, что оно принадлежит к этому классу.
Преимущество Наивного Байеса заключается в его быстрой и простой реализации. Он хорошо работает с многомерными данными (такими как текст) и может обрабатывать пропущенные значения. Однако предположение о независимости не всегда верно в реальной жизни, что иногда может привести к менее точным результатам по сравнению с более сложными алгоритмами.
 Проверьте себя
В этом уроке есть небольшой тест. Начните урок, чтобы ответить на вопросы и сохранить прогресс.
Проверьте себяВ этом уроке есть небольшой тест. Начните урок, чтобы ответить на вопросы и сохранить прогресс.
Проверьте себяВ этом уроке есть небольшой тест. Начните урок, чтобы ответить на вопросы и сохранить прогресс.

Задание
СреднеВ этом испытании мы научимся вычислять вероятность принадлежности к определенному классу. Набор данных play_outside.csv содержит следующие столбцы: temperature, mood, motivation, windy, play. Каждая строка представляет одного и того же человека и то, решил ли он пойти гулять или нет, основываясь на признаках (temperature, mood, motivation, windy). Наша цель — предсказать, пойдет ли он играть на улицу, основываясь на признаках (temperature, mood, motivation, windy).
Вот пример набора данных:
| temperature | mood | motivation | windy | play |
| low | good | high | no | yes |
| moderate | good | high | no | yes |
| low | low | medium | yes | no |
Следующие уравнения могут показаться пугающими, но мы разберем их по частям.
Формула Наивного Байеса: P(Class|Feature) = P(Feature|Class) * P(Class) / P(Feature)
- P(Feature|Class) — Правдоподобие (Likelihood)
- P(Class) — Априорная вероятность класса
- P(Feature) — Априорная вероятность предиктора
- P(Class|Feature) — Другими словами, какова вероятность того, что невидимая строка будет отнесена к классу
<strong>x</strong>.
Чтобы решить эту задачу, нам нужно будет вычислить каждый из компонентов формулы (P(B|Class) * P(Class) / P(B))
- P(Class) — Априорная вероятность класса
Это равно количеству вхождений каждого класса, деленному на общее количество классов. Например, в нашем примере из 3 строк есть2/3yes и1/3no.P(yes) = 2/3P(no) = 1/3 - P(Feature|Class) — Правдоподобие
Это равно количеству вхождений каждого признака для данного класса. Например:P(temperature = <strong>low</strong>|play = <strong>yes</strong>)— Есть две строки, гдеplay = yes, и одна строка, гдеtemperature = low(только среди строк, гдеplay = yes), поэтому это равно1/2. - P(Feature)
Это равно количеству вхождений каждого признака, деленному на общее количество строк. Например:p(motivation=high) = 2/3, потому что есть две строки с high motivation, деленные на общее количество строк (3)
Задача
Вам даны два словаря probability_features, probability_target и dataset_name
Вычислите для каждого признака (столбца) вероятность каждого атрибута.
Например, вот значение probability_target:
probability_target = {
    "yes": 0.66667, # (2/3)
    "no": 0.33333 # (1/3)
}
Вот значение probability_features:
probability_features = {
	"temperature": {
		"low": {
			"yes": 0.5, # (1/2)
			"no": 0.5, # (1/2)
		},
		"moderate": {
			"yes": 1, # (1/1)
			"no": 0, # (0/1)
		}
	}
}
Имейте в виду, что названия признаков и названия атрибутов не являются постоянными. Каждый набор данных имеет разные признаки и разные названия.
Я бы рекомендовал использовать модуль pandas, чтобы упростить вычисления.
Попробуйте сами
import pandas as pd
probability_features = {}
probability_target = {}
dataset_path = input()
target_variable = input()
df = pd.read_csv(dataset_path)
# Напишите свой код здесь


# -------------------- Сортировка и вывод --------------------
# Не изменяйте код ниже этой строки
sort_features = {q: {k: v for k, v in sorted(a.items() if a != None else {}, key=lambda item: item[0])} for q, a in sorted(probability_features.items(), key=lambda item: item[0])}
sort_target = {k: v for k, v in sorted(probability_target.items(), key=lambda item: item[0])}
print(sort_features)
print(sort_target)Все уроки раздела Введение в машинное обучение


Потренируйтесь самостоятельно: Онлайн-компилятор Python