





Метод опорных векторов (SVM)
Урок 18 из 19 курса Введение в машинное обучение на Coddy.
Метод опорных векторов (SVM) — это мощный и универсальный алгоритм машинного обучения с учителем, используемый как для задач классификации, так и для регрессии. Однако чаще всего он применяется в задачах классификации. SVM обеспечивают высокую точность и хорошо работают в многомерном пространстве признаков, что делает их подходящими для приложений, варьирующихся от распознавания изображений до биоинформатики.
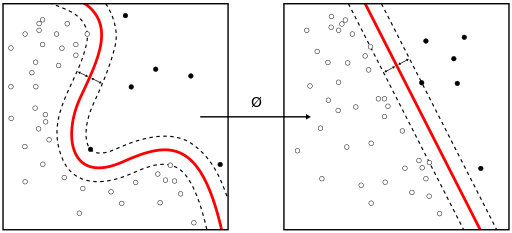
Источник: wikipedia
Основная цель алгоритма SVM — найти оптимальную гиперплоскость (в двумерном пространстве это линия), которая наилучшим образом разделяет классы в пространстве признаков. Модель SVM представляет примеры как точки в пространстве, отображенные таким образом, чтобы примеры отдельных категорий были разделены четким зазором, максимально широким.
- Гиперплоскость: По сути, это решающая граница, разделяющая классы. В 2D эта гиперплоскость представляет собой линию, но в более высоких измерениях она может быть сложнее.
- Опорные векторы: Это точки данных, ближайшие к гиперплоскости, которые имеют решающее значение для определения положения гиперплоскости. Классификатор SVM сильно зависит от этих точек, отсюда и название
Support VectorMachine. - Зазор (Margin): Это расстояние между двумя линиями на ближайших точках данных разных классов. Его можно рассматривать как меру разделения между классами. Обеспечение максимально широкого зазора является ключевой целью при обучении SVM.
Типы SVM:
- Линейный SVM: Когда данные линейно разделимы, мы можем использовать одну прямую линию для разделения классов. В этом сценарии используется линейный SVM.
- Нелинейный SVM: Когда данные не являются линейно разделимыми, SVM использует так называемый «ядерный трюк» (kernel trick) для преобразования входного пространства в пространство более высокой размерности, где для разделения можно использовать гиперплоскость. Ядерный трюк включает в себя преобразование данных в другое измерение, которое имеет четкий зазор между классами данных. Это позволяет SVM решать нелинейные задачи. Распространенные ядра включают:
- Линейное ядро: Используется, когда данные линейно разделимы.
- Полиномиальное ядро: Преобразует исходное пространство признаков в полиномиальное пространство признаков заданной степени.
- Ядро Гаусса: Полезно для нелинейных данных, которые группируются в кластеры. Оно отображает пространство признаков в более высокие измерения.
 Проверьте себя
В этом уроке есть небольшой тест. Начните урок, чтобы ответить на вопросы и сохранить прогресс.
Проверьте себяВ этом уроке есть небольшой тест. Начните урок, чтобы ответить на вопросы и сохранить прогресс.
Проверьте себяВ этом уроке есть небольшой тест. Начните урок, чтобы ответить на вопросы и сохранить прогресс.

Задание
ЛегкоМетод опорных векторов (SVM) использует функции ядра для преобразования данных в пространство более высокой размерности, где их легче классифицировать. Этот процесс известен как «ядерный трюк». Он позволяет SVM эффективно решать задачи нелинейной классификации и регрессии.
Здесь мы изучим полиномиальное ядро, позволяющее создавать криволинейные границы в данных. Оно возводит данные в заданную степень d. Это ядро особенно полезно, когда связь между метками классов и атрибутами является полиномиальной.
Источник: wikipedia
Создайте функцию с именем polynomial_kernel, которая принимает два списка (x, y), степень (d) и коэффициент (c) и возвращает полиномиальное ядро.

x скалярно умноженный на y плюс c ) в степени d.
Попробуйте сами
import numpy as np
def polynomial_kernel(x, y, d, c):
    x_arr = np.array(x)
    y_arr = np.array(y)
# Напишите свой код здесьВсе уроки раздела Введение в машинное обучение


6Другие модели
Логистическая регрессияЛинейная регрессияДерево решенийМетод опорных векторов (SVM)Тест по моделямПотренируйтесь самостоятельно: Онлайн-компилятор Python