





Introdução ao K-Means
Lição 9 de 19 do curso Introdução ao aprendizado de máquina da Coddy.
K-means é um dos algoritmos de agrupamento (clustering) mais simples e amplamente utilizados. Ele visa particionar n observações em k clusters, nos quais cada observação pertence ao cluster com a média (centroide) mais próxima, servindo como um protótipo do cluster. Digamos que você tenha um monte de frutas diferentes e queira separá-las em cestas com base no tipo, mas não possui os rótulos. O K-means ajuda você a fazer exatamente isso, mas com pontos de dados em vez de frutas!
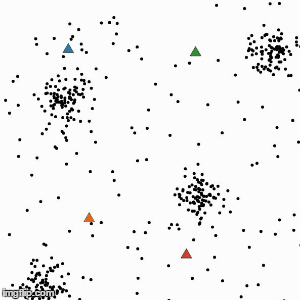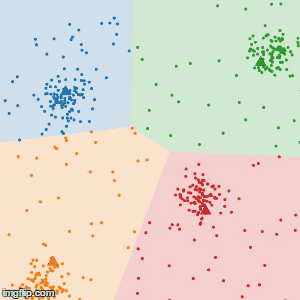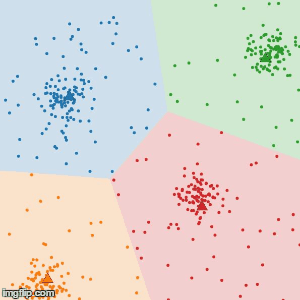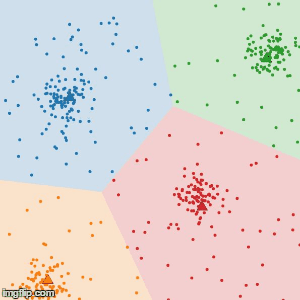
Incheol, CC BY-SA 4.0, via Wikimedia Commons
Como o K-Means Funciona?
O algoritmo segue um procedimento iterativo simples e eficiente para dividir um conjunto de dados em k clusters.
- Inicializar Centroides: Primeiro, escolha
kpontos como os centroides iniciais do conjunto de dados. Esses pontos podem ser selecionados aleatoriamente ou com base em uma estratégia específica. - Atribuir Clusters: Para cada ponto no conjunto de dados, encontre o centroide mais próximo (usando medidas de distância como a distância Euclidiana) e atribua o ponto a esse cluster.
- Atualizar Centroides: Assim que todos os pontos forem atribuídos aos clusters, recalcule os centroides tirando a média de todos os pontos em cada cluster.
- Repetir os Passos 2 e 3: Os passos acima são repetidos até que os centroides não mudem mais significativamente. Isso significa que o algoritmo convergiu e os clusters estão estáveis.
 Teste seus conhecimentos
Esta lição inclui um quiz rápido. Comece a lição para respondê-lo e acompanhar seu progresso.
Teste seus conhecimentosEsta lição inclui um quiz rápido. Comece a lição para respondê-lo e acompanhar seu progresso.
Teste seus conhecimentosEsta lição inclui um quiz rápido. Comece a lição para respondê-lo e acompanhar seu progresso.

Desafio
FácilDeterminar o número ideal de clusters, k, é uma etapa crucial. Existem vários métodos para isso, sendo o Método do Cotovelo (Elbow Method) um dos mais populares.
Esta técnica envolve a execução contínua do K-means iterando de k=1 até k=n. Para cada valor de k, calculamos o valor da soma dos quadrados dentro do cluster (WCSS - within-cluster sum of squares).
Cada cluster possui um centroide; o WCSS é a soma de todas as distâncias do centroide ao quadrado.
Crie uma função chamada wcss que receba uma lista de pontos de dados (do mesmo cluster) e retorne o wcss do cluster. Siga estas etapas:
Encontre o centroide - Um centroide é um ponto que representa a posição média de todos os pontos em um cluster:
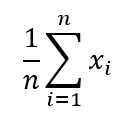
Por exemplo, aqui está uma lista de dois pontos 3D:(1, 2 ,3), (4, 5, 6). O centroide é:(1 + 4) / 2 = 2.5, (2 + 5) / 2 = 3.5, (3 + 6) / 2 = 4.5, >> (2.5, 3.5, 4.5)- Calcule a distância Euclidiana entre cada ponto e o centroide
- Retorne a soma de todas as distâncias dividida pelo número de pontos
Experimente você mesmo
def euclidian_distance(point_a, point_b):
    return (sum([(point_a[i] - point_b[i])**2 for i in range(len(point_a))]))**0.5

def wcss(points):
# Escreva o código aquiTodas as lições de Introdução ao aprendizado de máquina

Pratique por conta própria: Compilador de Python online