





Introdução ao Naive Bayes
Lição 12 de 19 do curso Introdução ao aprendizado de máquina da Coddy.
Naive Bayes é um algoritmo simples, porém poderoso, usado para tarefas de classificação em machine learning.
O algoritmo Naive Bayes é baseado no teorema de Bayes, que nos diz como calcular a probabilidade de um evento (como um e-mail ser spam) com base no conhecimento prévio de condições que podem estar relacionadas ao evento. A parte "naive" (ingênua) vem da suposição de que todas as características (como as palavras no e-mail) são independentes umas das outras, o que simplifica os cálculos. Ser independente significa que o acontecimento de uma coisa não altera as chances de outra coisa acontecer.
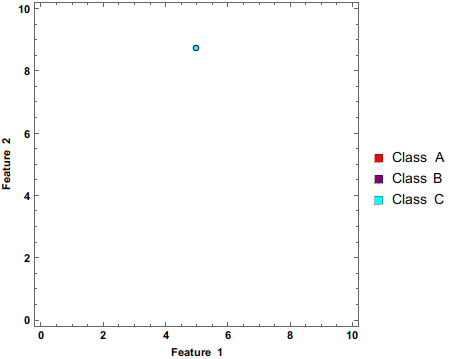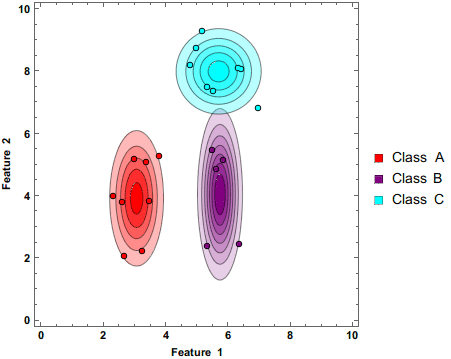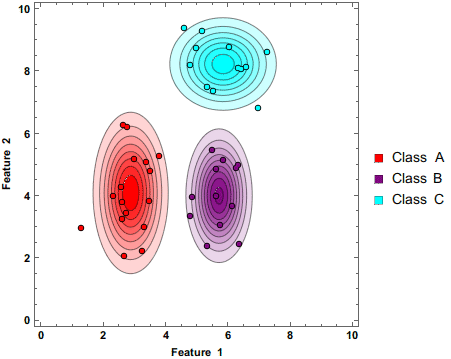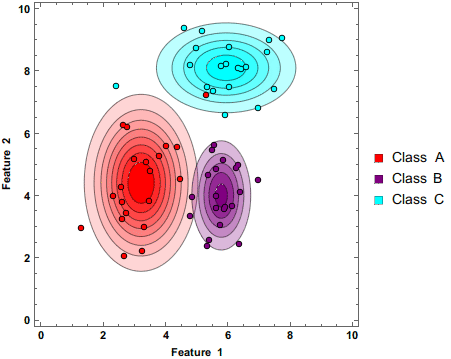
Fonte: Wikipedia, Um Classificador Naive Bayes atualizando sua estimativa enquanto mais dados são fornecidos a ele.
Veja como funciona:
- Contar Ocorrências: Primeiro, conte quantas vezes cada ponto de dados aparece em diferentes classes. Na detecção de spam de e-mail, contaremos quantas vezes cada palavra apareceu em e-mails de spam ou não spam; no diagnóstico médico, podemos contar quantas vezes (ou por quanto tempo) cada sintoma aparece.
- Calcular Probabilidades: Para um novo ponto de dados, calcule a probabilidade de pertencer a cada classe (qual é a probabilidade de um novo e-mail ser spam e qual é a probabilidade de não ser spam)
- Decisão: Finalmente, o algoritmo combina todas essas probabilidades usando o teorema de Bayes e decide se o e-mail tem mais probabilidade de ser spam ou não spam. Quanto maior a probabilidade, maior a probabilidade de pertencer a esta classe.
O legal do Naive Bayes é sua implementação rápida e fácil. Ele funciona bem com dados de alta dimensão (como texto) e pode lidar com valores ausentes. No entanto, a suposição de independência nem sempre é verdadeira na vida real, o que às vezes pode levar a resultados menos precisos em comparação com algoritmos mais complexos.
 Teste seus conhecimentos
Esta lição inclui um quiz rápido. Comece a lição para respondê-lo e acompanhar seu progresso.
Teste seus conhecimentosEsta lição inclui um quiz rápido. Comece a lição para respondê-lo e acompanhar seu progresso.
Teste seus conhecimentosEsta lição inclui um quiz rápido. Comece a lição para respondê-lo e acompanhar seu progresso.

Desafio
MédioNeste desafio, aprenderemos como calcular a probabilidade de pertencer a uma classe específica. O conjunto de dados play_outside.csv contém as seguintes colunas: temperature, mood, motivation, windy, play. Cada linha representa a mesma pessoa e se ela decidiu brincar lá fora ou não com base nas características (temperature, mood, motivation, windy). Nosso objetivo é prever se ela irá brincar lá fora com base nas características (temperature, mood, motivation, windy).
Aqui está um exemplo de um conjunto de dados:
| temperature | mood | motivation | windy | play |
| low | good | high | no | yes |
| moderate | good | high | no | yes |
| low | low | medium | yes | no |
As seguintes equações podem parecer intimidantes, mas vamos detalhá-las.
Fórmula de Naive Bayes: P(Class|Feature) = P(Feature|Class) * P(Class) / P(Feature)
- P(Feature|Class) - Verossimilhança (Likelihood)
- P(Class) - Probabilidade a priori da classe
- P(Feature) - Probabilidade a priori do preditor
- P(Class|Feature) - Em outras palavras, qual é a probabilidade de a linha não vista ser classificada na classe
<strong>x</strong>.
Para resolver isso, precisaremos calcular cada um dos componentes da fórmula (P(B|Class) * P(Class) / P(B))
- P(Class) - Probabilidade a priori da classe
Isso equivale ao número de ocorrências de cada classe, dividido pelo número total de classes. Por exemplo, em nosso exemplo de 3 linhas, há2/3yes e1/3no.P(yes) = 2/3P(no) = 1/3 - P(Feature|Class) - Verossimilhança (Likelihood)
Isso equivale ao número de ocorrências de cada característica de uma determinada classe. Por exemplo:P(temperature = <strong>low</strong>|play = <strong>yes</strong>)- Existem duas linhas ondeplay = yes, e uma linha ondetemperature = low(apenas das linhas ondeplay = yes), então isso equivale a1/2. - P(Feature)
Isso equivale ao número de ocorrências de cada característica dividido pelo número total de linhas. Por exemplo:p(motivation=high) = 2/3porque existem duas linhas com alta motivação divididas pelo número total de linhas (3)
O desafio
Você recebe dois dicionários probability_features, probability_target e o dataset_name
Calcule para cada característica (coluna) a probabilidade de cada atributo.
Por exemplo, aqui está o valor de probability_target :
probability_target = {
    "yes": 0.66667, # (2/3)
    "no": 0.33333 # (1/3)
}
Aqui está o valor de probability_features:
probability_features = {
	"temperature": {
		"low": {
			"yes": 0.5, # (1/2)
			"no": 0.5, # (1/2)
		},
		"moderate": {
			"yes": 1, # (1/1)
			"no": 0, # (0/1)
		}
	}
}
Tenha em mente que os nomes das características e os nomes dos atributos não são constantes. Cada conjunto de dados possui características diferentes e nomes diferentes.
Eu recomendaria usar o módulo pandas para facilitar os cálculos.
Experimente você mesmo
import pandas as pd
probability_features = {}
probability_target = {}
dataset_path = input()
target_variable = input()
df = pd.read_csv(dataset_path)
# Escreva seu código aqui


# -------------------- Ordenar e imprimir --------------------
# Não altere nada abaixo desta linha
sort_features = {q: {k: v for k, v in sorted(a.items() if a != None else {}, key=lambda item: item[0])} for q, a in sorted(probability_features.items(), key=lambda item: item[0])}
sort_target = {k: v for k, v in sorted(probability_target.items(), key=lambda item: item[0])}
print(sort_features)
print(sort_target)Todas as lições de Introdução ao aprendizado de máquina


Pratique por conta própria: Compilador de Python online