





Máquina de Vetores de Suporte (SVM)
Lição 18 de 19 do curso Introdução ao aprendizado de máquina da Coddy.
Support Vector Machine (SVM) é um algoritmo de aprendizado de máquina supervisionado poderoso e versátil, usado tanto para tarefas de classificação quanto de regressão. No entanto, é mais comumente usado em problemas de classificação. As SVMs oferecem alta precisão e apresentam bom desempenho com um espaço de características de alta dimensão, tornando-as adequadas para aplicações que variam de reconhecimento de imagem a bioinformática.
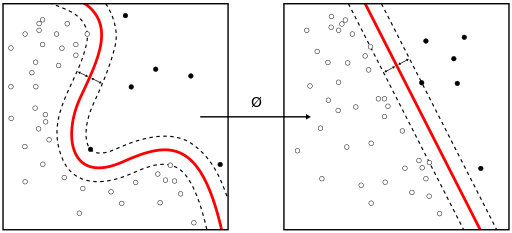
Fonte: wikipedia
O principal objetivo do algoritmo SVM é encontrar o hiperplano ideal (em um espaço bidimensional, trata-se de uma linha) que melhor separa as classes no espaço de características. O modelo SVM representa os exemplos como pontos no espaço, mapeados de tal forma que os exemplos de categorias separadas sejam divididos por uma lacuna clara que seja a mais larga possível.
- Hiperplano: Esta é basicamente uma fronteira de decisão que separa as classes. Em 2D, este hiperplano é uma linha, mas em dimensões superiores, pode ser mais complexo.
- Vetores de Suporte: Estes são os pontos de dados mais próximos do hiperplano, que são críticos na definição da posição do hiperplano. O classificador SVM é altamente influenciado por esses pontos, daí o nome
Support VectorMachine. - Margem: É a lacuna entre duas linhas nos pontos de dados mais próximos de diferentes classes. Pode ser considerada como uma medida de separação entre as classes. Garantir que a margem seja a mais larga possível é um objetivo fundamental no treinamento de uma SVM.
Tipos de SVM:
- SVM Linear: Quando os dados são linearmente separáveis, podemos usar uma única linha reta para separar as classes. Este cenário utiliza SVM linear.
- SVM Não-linear: Quando os dados não são linearmente separáveis, a SVM utiliza o que é chamado de truque de kernel para transformar o espaço de entrada em um espaço de dimensão superior, onde um hiperplano pode ser usado para realizar a separação. O truque de kernel envolve a transformação dos dados em outra dimensão que possua uma margem clara entre as classes de dados. Isso permite que a SVM resolva problemas não lineares. Kernels comuns incluem:
- Kernel Linear: Usado quando os dados são linearmente separáveis.
- Kernel Polinomial: Transforma o espaço de características original em um espaço de características polinomial de um grau especificado.
- Kernel Gaussiano: Útil para dados não lineares que se agrupam em grupos. Ele mapeia o espaço de características em dimensões superiores.
 Teste seus conhecimentos
Esta lição inclui um quiz rápido. Comece a lição para respondê-lo e acompanhar seu progresso.
Teste seus conhecimentosEsta lição inclui um quiz rápido. Comece a lição para respondê-lo e acompanhar seu progresso.
Teste seus conhecimentosEsta lição inclui um quiz rápido. Comece a lição para respondê-lo e acompanhar seu progresso.

Desafio
FácilAs Máquinas de Vetores de Suporte (SVMs) utilizam funções de kernel para transformar dados em um espaço de dimensão superior, onde é mais fácil classificá-los. Esse processo é conhecido como o "truque do kernel". Ele permite que as SVMs resolvam problemas de classificação e regressão não lineares de forma eficiente.
Aqui, exploraremos o kernel polinomial, que permite fronteiras curvas nos dados. Ele eleva os dados a um grau especificado d. Este kernel é particularmente útil quando a relação entre os rótulos das classes e os atributos é polinomial.
Fonte: wikipedia
Crie uma função chamada polynomial_kernel que recebe duas listas (x, y), um grau (d) e um coeficiente (c) e retorna o kernel polinomial.

x transposto por y somado a c) elevado à potência de d.
Experimente você mesmo
import numpy as np
def polynomial_kernel(x, y, d, c):
    x_arr = np.array(x)
    y_arr = np.array(y)
# Escreva seu código aquiTodas as lições de Introdução ao aprendizado de máquina


6Outros Modelos
Regressão LogísticaRegressão LinearÁrvore de DecisãoMáquina de Vetores de Suporte (SVM)Questionário sobre ModelosPratique por conta própria: Compilador de Python online