





Introdução ao KNN
Lição 6 de 19 do curso Introdução ao aprendizado de máquina da Coddy.
K-Nearest Neighbors (KNN) é um algoritmo de aprendizado supervisionado que é usado tanto para problemas de classificação quanto de regressão. Ele é simples, porém poderoso, e é frequentemente usado como uma linha de base para modelos mais complexos.
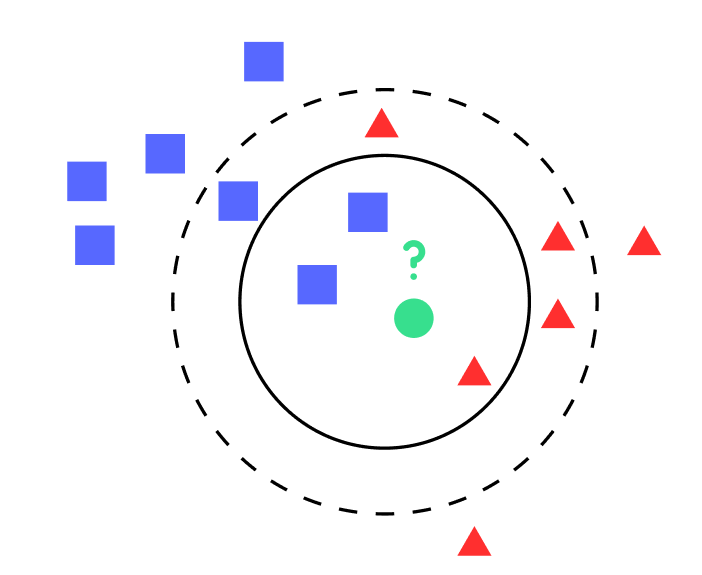
O algoritmo KNN encontra a similaridade de características usando métricas de distância para identificar os vizinhos mais próximos de um ponto. Por exemplo, ele pode classificar vinhos comparando-os com os mais próximos, como agrupar vinhos com sabores semelhantes. É como ter um guia que ajuda você a encontrar quais vinhos são parecidos com base em seus traços mais comuns. 🍷
A ideia por trás do KNN é bastante direta:
- Cálculo de Distância: Para um dado ponto de teste, o algoritmo calcula a distância entre esse ponto e todos os outros pontos no conjunto de dados de treinamento. A distância pode ser calculada de várias maneiras, como a distância Euclidiana ou de Manhattan.
- Encontrar os Vizinhos Mais Próximos: O algoritmo então seleciona os
kpontos nos dados de treinamento que estão mais próximos do ponto de teste.ké uma constante definida pelo usuário e pode ser qualquer número inteiro. - Fazer Predição: Para classificação, o algoritmo atribui o rótulo de classe mais comum entre os
kvizinhos mais próximos ao ponto de teste. Para regressão, ele atribui a média dos ‘k’ vizinhos mais próximos.
O KNN é um algoritmo de aprendizado preguiçoso (lazy learning), o que significa que ele não aprende de fato um modelo. Em vez disso, ele memoriza as instâncias de treinamento e as utiliza para predição (a próxima lição cobrirá a fase de treinamento). Isso torna o KNN computacionalmente caro durante a fase de teste.
Apesar de sua simplicidade, o KNN pode alcançar um desempenho surpreendentemente bom. No entanto, ele é sensível à escolha de k e ao tipo de métrica de distância, e não apresenta um bom desempenho com dados de alta dimensão devido à maldição da dimensionalidade.
 Teste seus conhecimentos
Esta lição inclui um quiz rápido. Comece a lição para respondê-lo e acompanhar seu progresso.
Teste seus conhecimentosEsta lição inclui um quiz rápido. Comece a lição para respondê-lo e acompanhar seu progresso.
Teste seus conhecimentosEsta lição inclui um quiz rápido. Comece a lição para respondê-lo e acompanhar seu progresso.

Desafio
FácilNeste desafio, aprenderemos diferentes cálculos de distância.
Crie uma função chamada distances_option_calculator que recebe três variáveis: X, y e distance_type. A função retornará a distância entre X e y de acordo com o distance_type.
Aqui está uma lista de cálculos de distância comuns:
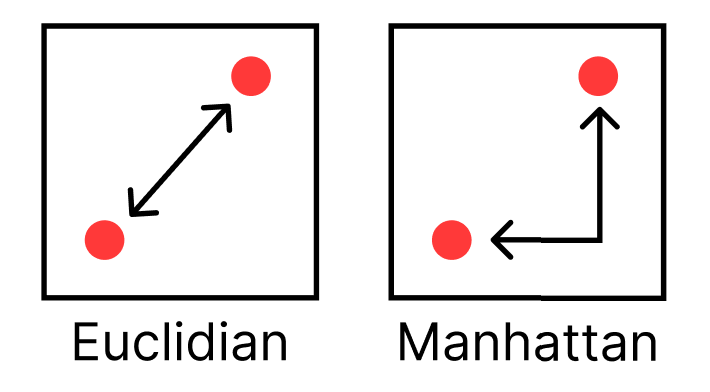
Distância Euclidian (A mais comum) A distância em linha reta entre dois pontos. A raiz quadrada da soma dos quadrados das diferenças entre cada coordenada correspondente dos pontos:
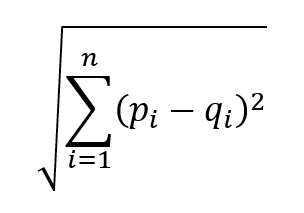
A distância Manhattan também é conhecida como distância de Taxicab ou City Block. A soma das diferenças absolutas entre os pontos em todas as dimensões. Para dois pontos ( P ) e ( Q ), com coordenadas ( (p_1, p_2, …, p_n) ) e ( (q_1, q_2, …, q_n) ) respectivamente:
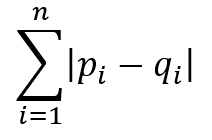
Distância Hamming: O número de posições nas quais os símbolos correspondentes são diferentes. É frequentemente usada para dados categóricos.
Por exemplo, vamos pegar duas strings binárias:
String 1: 1101
String 2: 1001
Comparando-as posição por posição, vemos que a segunda posição tem bits diferentes (1 na String 1 e 0 na String 2). Todas as outras posições são iguais. Portanto, a distância Hamming entre essas duas strings é 1.
O distance_type pode ter os seguintes itens: "hamming", "manhattan", "euclidian".
Experimente você mesmo
def distances_option_calculator(X, y, distance_type):
    # Escreva o código aqui
    if distance_type == "euclidian":
        pass
    elif distance_type == "manhattan":
        pass
    elif distance_type == "hamming":
passTodas as lições de Introdução ao aprendizado de máquina

Pratique por conta própria: Compilador de Python online