





Introducción a K-Means
Lección 9 de 19 del curso Introducción al aprendizaje automático de Coddy.
K-means es uno de los algoritmos de agrupamiento (clustering) más simples y utilizados. Su objetivo es dividir n observaciones en k grupos (clusters) en los que cada observación pertenece al grupo con la media (centroide) más cercana, sirviendo como prototipo del grupo. Digamos que tienes un montón de frutas diferentes y quieres clasificarlas en cestas según su tipo, pero no tienes las etiquetas. ¡K-means te ayuda a hacer precisamente eso, pero con puntos de datos en lugar de fruta!
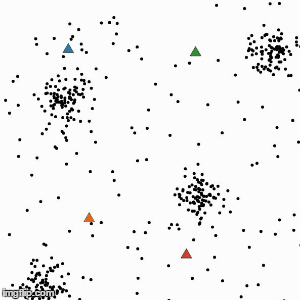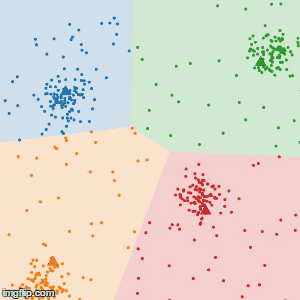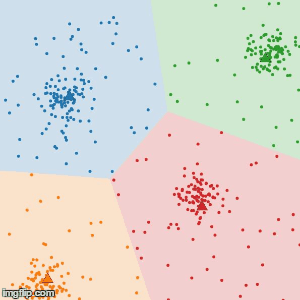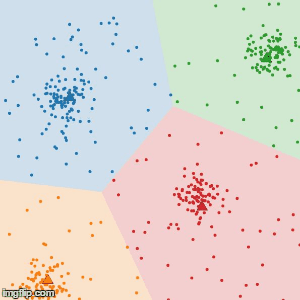
Incheol, CC BY-SA 4.0, a través de Wikimedia Commons
¿Cómo funciona K-Means?
El algoritmo sigue un procedimiento iterativo simple y eficiente para dividir un conjunto de datos en k grupos.
- Inicializar Centroides: Primero, elige
kpuntos como los centroides iniciales del conjunto de datos. Estos puntos pueden seleccionarse al azar o basándose en una estrategia específica. - Asignar Grupos: Para cada punto en el conjunto de datos, encuentra el centroide más cercano (usando medidas de distancia como la distancia euclidiana) y asigna el punto a ese grupo.
- Actualizar Centroides: Una vez que todos los puntos están asignados a los grupos, recalcula los centroides tomando la media de todos los puntos en cada grupo.
- Repetir los Pasos 2 y 3: Los pasos anteriores se repiten hasta que los centroides ya no cambien significativamente. Esto significa que el algoritmo ha convergido y los grupos son estables.
 Ponte a prueba
Esta lección incluye un breve cuestionario. Empieza la lección para responderlo y registrar tu progreso.
Ponte a pruebaEsta lección incluye un breve cuestionario. Empieza la lección para responderlo y registrar tu progreso.
Ponte a pruebaEsta lección incluye un breve cuestionario. Empieza la lección para responderlo y registrar tu progreso.

Desafío
FácilDeterminar el número óptimo de clústeres, k, es un paso crucial. Existen varios métodos para esto, siendo el Método del Codo (Elbow Method) uno de los más populares.
Esta técnica consiste en ejecutar K-means de forma iterativa desde k=1 hasta k=n. Para cada valor de k, calculamos el valor de la suma de cuadrados dentro del clúster (WCSS).
Cada clúster tiene un centroide; el WCSS es la suma de todas las distancias desde el centroide al cuadrado.
Crea una función llamada wcss que reciba una lista de puntos de datos (del mismo clúster) y devuelva el wcss del clúster. Sigue estos pasos:
Encuentra el centroide - Un centroide es un punto que representa la posición promedio de todos los puntos en un clúster:
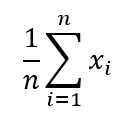
Por ejemplo, aquí hay una lista de dos puntos 3D:(1, 2 ,3), (4, 5, 6). El centroide es:(1 + 4) / 2 = 2.5, (2 + 5) / 2 = 3.5, (3 + 6) / 2 = 4.5, >> (2.5, 3.5, 4.5)- Calcula la distancia euclidiana entre cada punto y el centroide
- Devuelve la suma de todas las distancias dividida por el número de puntos
Pruébalo tú mismo
def euclidian_distance(point_a, point_b):
    return (sum([(point_a[i] - point_b[i])**2 for i in range(len(point_a))]))**0.5

def wcss(points):
# Escribe el código aquíTodas las lecciones de Introducción al aprendizaje automático

Practica por tu cuenta: Compilador de Python online