





Introducción a Naive Bayes
Lección 12 de 19 del curso Introducción al aprendizaje automático de Coddy.
Naive Bayes es un algoritmo simple pero potente utilizado para tareas de clasificación en el aprendizaje automático (machine learning).
El algoritmo Naive Bayes se basa en el teorema de Bayes, que nos indica cómo calcular la probabilidad de un evento (como que un correo electrónico sea spam) basándose en el conocimiento previo de las condiciones que podrían estar relacionadas con el evento. La parte "naive" (ingenuo) proviene de la suposición de que todas las características (como las palabras en el correo electrónico) son independientes entre sí, lo que simplifica los cálculos. Ser independiente significa que el hecho de que ocurra una cosa no cambia las probabilidades de que ocurra otra.
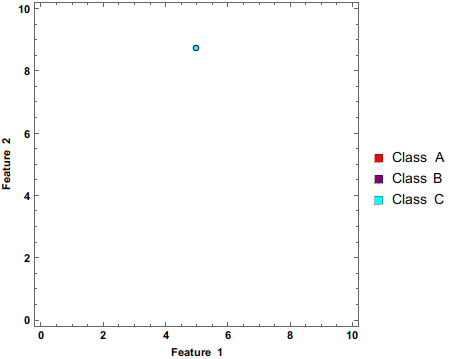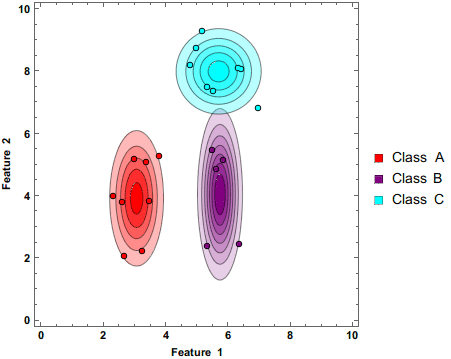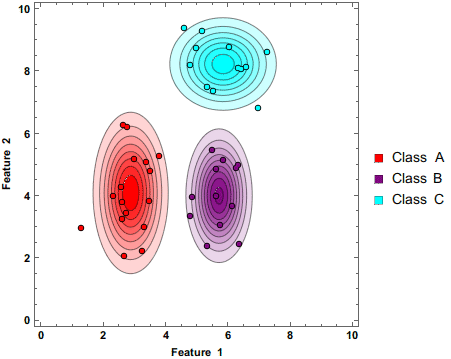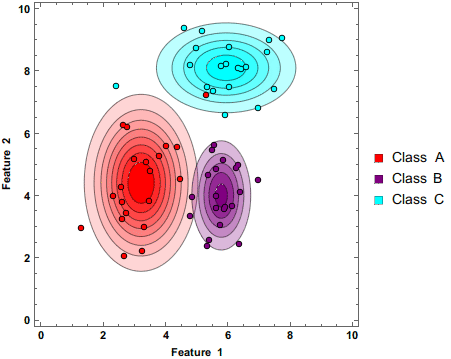
Fuente: Wikipedia, un clasificador Naive Bayes actualizando su estimación mientras se le suministran más datos.
Así es como funciona:
- Contar ocurrencias: Primero, cuenta cuántas veces aparece cada punto de datos en diferentes clases. En la detección de spam de correo electrónico, contaremos cuántas veces apareció cada palabra en correos electrónicos de spam o no spam; en el diagnóstico médico, podríamos contar cuántas veces (o durante cuánto tiempo) aparece cada síntoma.
- Calcular probabilidades: Para un nuevo punto de datos, calcula la probabilidad de pertenecer a cada clase (cuál es la probabilidad de que un nuevo correo electrónico sea spam y cuál es la probabilidad de que no sea spam).
- Decisión: Finalmente, el algoritmo combina todas estas probabilidades utilizando el teorema de Bayes y decide si es más probable que el correo electrónico sea spam o no spam. Cuanto mayor sea la probabilidad, más probable es que pertenezca a esa clase.
Lo genial de Naive Bayes es su implementación rápida y sencilla. Funciona bien con datos de alta dimensión (como el texto) y puede manejar valores faltantes. Sin embargo, la suposición de independencia no siempre es cierta en la vida real, lo que a veces puede llevar a resultados menos precisos en comparación con algoritmos más complejos.
 Ponte a prueba
Esta lección incluye un breve cuestionario. Empieza la lección para responderlo y registrar tu progreso.
Ponte a pruebaEsta lección incluye un breve cuestionario. Empieza la lección para responderlo y registrar tu progreso.
Ponte a pruebaEsta lección incluye un breve cuestionario. Empieza la lección para responderlo y registrar tu progreso.

Desafío
IntermedioEn este desafío, aprenderemos cómo calcular la probabilidad de pertenecer a una clase en particular. El conjunto de datos play_outside.csv contiene las siguientes columnas: temperature, mood, motivation, windy, play. Cada fila representa a la misma persona y si decidió jugar afuera o no basándose en las características (temperature, mood, motivation, windy). Nuestro objetivo es predecir si saldrá a jugar afuera basándonos en las características (temperature, mood, motivation, windy).
Aquí hay un ejemplo de un conjunto de datos:
| temperature | mood | motivation | windy | play |
| low | good | high | no | yes |
| moderate | good | high | no | yes |
| low | low | medium | yes | no |
Las siguientes ecuaciones pueden parecer intimidantes, pero las desglosaremos.
Fórmula de Naive Bayes: P(Class|Feature) = P(Feature|Class) * P(Class) / P(Feature)
- P(Feature|Class) - Verosimilitud (Likelihood)
- P(Class) - Probabilidad a priori de la clase
- P(Feature) - Probabilidad a priori del predictor
- P(Class|Feature) - En otras palabras, ¿cuál es la probabilidad de que la fila no vista sea clasificada en la clase
<strong>x</strong>?
Para resolver esto, necesitaremos calcular cada uno de los componentes de la fórmula (P(B|Class) * P(Class) / P(B))
- P(Class) - Probabilidad a priori de la clase
Esto equivale al número de ocurrencias de cada clase, dividido por el número total de clases. Por ejemplo, en nuestro ejemplo de 3 filas, hay2/3yes y1/3no.P(yes) = 2/3P(no) = 1/3 - P(Feature|Class) - Verosimilitud (Likelihood)
Esto equivale al número de ocurrencias de cada característica de una clase dada. Por ejemplo:P(temperature = <strong>low</strong>|play = <strong>yes</strong>)- Hay dos filas dondeplay = yes, y una fila dondetemperature = low(solo de las filas dondeplay = yes), por lo que esto equivale a1/2. - P(Feature)
Esto equivale al número de ocurrencias de cada característica dividido por el número total de filas. Por ejemplo:p(motivation=high) = 2/3porque hay dos filas con motivación alta divididas por el número total de filas (3)
El desafío
Se te dan dos diccionarios probability_features, probability_target y el dataset_name
Calcula para cada característica (columna) la probabilidad de cada atributo.
Por ejemplo, aquí está el valor de probability_target:
probability_target = {
    "yes": 0.66667, # (2/3)
    "no": 0.33333 # (1/3)
}
Aquí está el valor de probability_features:
probability_features = {
	"temperature": {
		"low": {
			"yes": 0.5, # (1/2)
			"no": 0.5, # (1/2)
		},
		"moderate": {
			"yes": 1, # (1/1)
			"no": 0, # (0/1)
		}
	}
}
Ten en cuenta que los nombres de las características y los nombres de los atributos no son constantes. Cada conjunto de datos tiene diferentes características y diferentes nombres.
Recomendaría usar el módulo pandas para facilitar los cálculos.
Pruébalo tú mismo
import pandas as pd
probability_features = {}
probability_target = {}
dataset_path = input()
target_variable = input()
df = pd.read_csv(dataset_path)
# Escribe tu código aquí


# -------------------- Ordenar e imprimir --------------------
# No cambies nada debajo de esta línea
sort_features = {q: {k: v for k, v in sorted(a.items() if a != None else {}, key=lambda item: item[0])} for q, a in sorted(probability_features.items(), key=lambda item: item[0])}
sort_target = {k: v for k, v in sorted(probability_target.items(), key=lambda item: item[0])}
print(sort_features)
print(sort_target)Todas las lecciones de Introducción al aprendizaje automático


Practica por tu cuenta: Compilador de Python online