





Introducción a KNN
Lección 6 de 19 del curso Introducción al aprendizaje automático de Coddy.
K-Nearest Neighbors (KNN) es un algoritmo de aprendizaje supervisado que se utiliza tanto para problemas de clasificación como de regresión. Es simple pero potente y a menudo se utiliza como base para modelos más complejos.
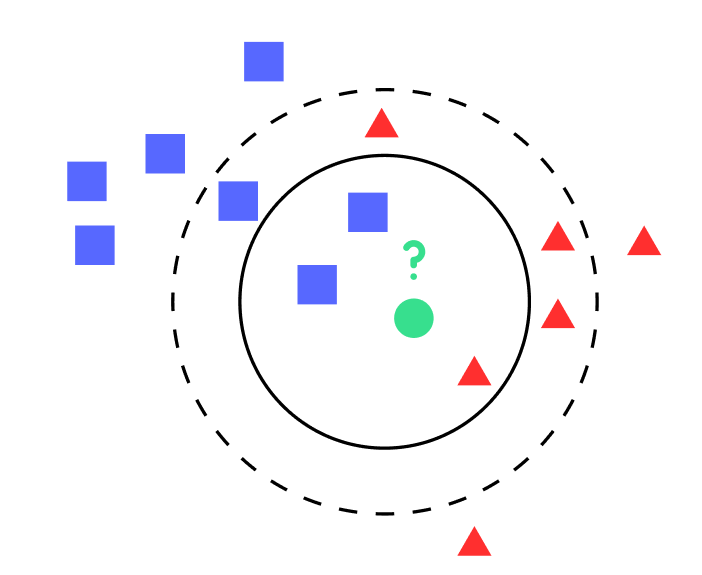
El algoritmo KNN encuentra la similitud de características utilizando métricas de distancia para identificar los vecinos más cercanos a un punto. Por ejemplo, puede clasificar vinos comparándolos con los más cercanos, como agrupar vinos con sabores similares. Es como tener un guía que te ayuda a encontrar qué vinos se parecen en función de sus rasgos más comunes. 🍷
La idea detrás de KNN es bastante sencilla:
- Cálculo de Distancia: Para un punto de prueba dado, el algoritmo calcula la distancia entre ese punto y todos los demás puntos del conjunto de datos de entrenamiento. La distancia se puede calcular de varias maneras, como la distancia euclidiana o la de Manhattan.
- Encontrar los Vecinos más Cercanos: El algoritmo selecciona entonces los
kpuntos en los datos de entrenamiento que están más cerca del punto de prueba.kes una constante definida por el usuario y puede ser cualquier número entero. - Realizar Predicción: Para la clasificación, el algoritmo asigna la etiqueta de clase más común entre los
kvecinos más cercanos al punto de prueba. Para la regresión, asigna el promedio de los ‘k’ vecinos más cercanos.
KNN es un algoritmo de aprendizaje perezoso (lazy learning), lo que significa que en realidad no aprende un modelo. En su lugar, memoriza las instancias de entrenamiento y las utiliza para la predicción (la próxima lección cubrirá la fase de entrenamiento). Esto hace que KNN sea computacionalmente costoso durante la fase de prueba.
A pesar de su simplicidad, KNN puede lograr un rendimiento sorprendentemente bueno. Sin embargo, es sensible a la elección de k y al tipo de métrica de distancia, y no funciona bien con datos de alta dimensión debido a la maldición de la dimensionalidad.
 Ponte a prueba
Esta lección incluye un breve cuestionario. Empieza la lección para responderlo y registrar tu progreso.
Ponte a pruebaEsta lección incluye un breve cuestionario. Empieza la lección para responderlo y registrar tu progreso.
Ponte a pruebaEsta lección incluye un breve cuestionario. Empieza la lección para responderlo y registrar tu progreso.

Desafío
FácilEn este desafío, aprenderemos diferentes cálculos de distancia.
Crea una función llamada distances_option_calculator que reciba tres variables: X, y y distance_type. La función devolverá la distancia entre X e y según el distance_type.
Aquí tienes una lista de cálculos de distancia comunes:
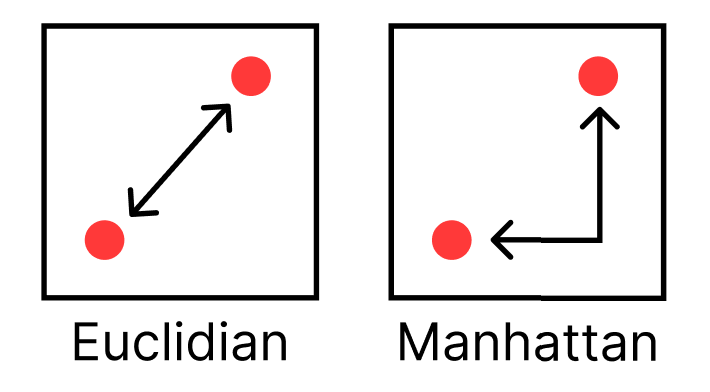
Distancia Euclidian (La más común) La distancia en línea recta entre dos puntos. La raíz cuadrada de la suma de los cuadrados de las diferencias entre cada coordenada correspondiente de los puntos:
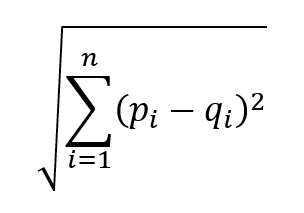
La distancia Manhattan también es conocida como distancia Taxicab o City Block. Es la suma de las diferencias absolutas entre los puntos en todas las dimensiones. Para dos puntos ( P ) y ( Q ), con coordenadas ( (p_1, p_2, …, p_n) ) y ( (q_1, q_2, …, q_n) ) respectivamente:
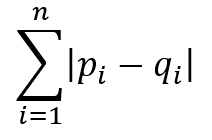
Distancia Hamming: El número de posiciones en las que los símbolos correspondientes son diferentes. A menudo se utiliza para datos categóricos.
Por ejemplo, tomemos dos cadenas binarias:
String 1: 1101
String 2: 1001
Al compararlas posición por posición, vemos que la segunda posición tiene bits diferentes (1 en String 1 y 0 en String 2). Todas las demás posiciones son iguales. Por lo tanto, la distancia Hamming entre estas dos cadenas es 1.
El distance_type puede tener los siguientes elementos: "hamming", "manhattan", "euclidian".
Pruébalo tú mismo
def distances_option_calculator(X, y, distance_type):
    # Escribe el código aquí
    if distance_type == "euclidian":
        pass
    elif distance_type == "manhattan":
        pass
    elif distance_type == "hamming":
passTodas las lecciones de Introducción al aprendizaje automático

Practica por tu cuenta: Compilador de Python online