





K-Means 소개
Coddy의 머신 러닝 입문 코스 레슨. 19개 중 9번째.
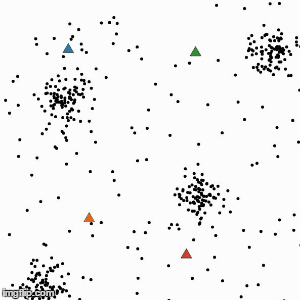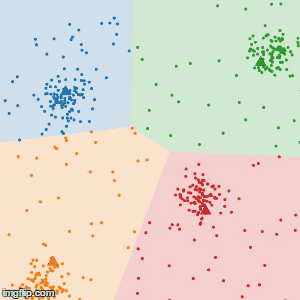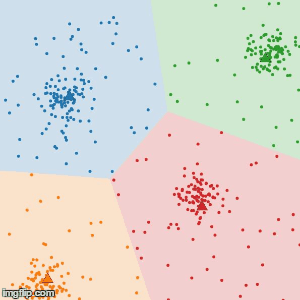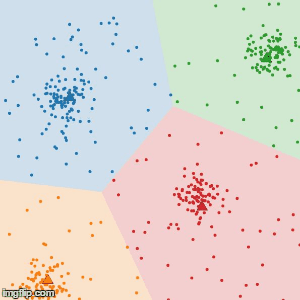
K-means는 가장 단순하고 널리 사용되는 클러스터링 알고리즘 중 하나입니다. 이는 n개의 관측치를 k개의 클러스터로 나누는 것을 목표로 하며, 각 관측치는 해당 클러스터의 프로토타입 역할을 하는 가장 가까운 평균(중심점)을 가진 클러스터에 속하게 됩니다. 여러 종류의 과일이 있고 이를 종류별로 바구니에 담고 싶지만 라벨이 없다고 가정해 봅시다. K-means는 과일 대신 데이터 포인트를 사용하여 바로 그 작업을 수행하도록 도와줍니다!
Incheol, CC BY-SA 4.0, Wikimedia Commons 제공
K-Means는 어떻게 작동하나요?
이 알고리즘은 데이터셋을 k개의 클러스터로 나누기 위해 간단하고 효율적인 반복 절차를 따릅니다.
- 중심점 초기화: 먼저, 데이터셋에서
k개의 포인트를 초기 중심점으로 선택합니다. 이 포인트들은 무작위로 선택되거나 특정 전략에 따라 선택될 수 있습니다. - 클러스터 할당: 데이터셋의 각 포인트에 대해, 가장 가까운 중심점을 찾고(유클리드 거리와 같은 거리 측정 방식 사용) 해당 포인트를 그 클러스터에 할당합니다.
- 중심점 업데이트: 모든 포인트가 클러스터에 할당되면, 각 클러스터에 속한 모든 포인트의 평균을 구하여 중심점을 다시 계산합니다.
- 2단계와 3단계 반복: 중심점이 더 이상 크게 변하지 않을 때까지 위의 단계들을 반복합니다. 이는 알고리즘이 수렴했음을 의미하며, 클러스터가 안정된 상태가 됩니다.
 실력 점검
이 레슨에는 짧은 퀴즈가 포함되어 있습니다. 레슨을 시작해 문제를 풀고 진행 상황을 기록하세요.
실력 점검이 레슨에는 짧은 퀴즈가 포함되어 있습니다. 레슨을 시작해 문제를 풀고 진행 상황을 기록하세요.
실력 점검이 레슨에는 짧은 퀴즈가 포함되어 있습니다. 레슨을 시작해 문제를 풀고 진행 상황을 기록하세요.

챌린지
쉬움최적의 클러스터 수인 k를 결정하는 것은 매우 중요한 단계입니다. 이를 위한 다양한 방법이 있으며, 그 중 엘보우 방법(Elbow Method)이 가장 인기 있는 방법 중 하나입니다.
이 기법은 k=1부터 k=n까지 K-means를 지속적으로 반복 실행하는 것을 포함합니다. 모든 k 값에 대해, 클러스터 내 오차 제곱합(WCSS) 값을 계산합니다.
각 클러스터에는 중심점(centroid)이 있으며, WCSS는 중심점으로부터의 모든 거리의 제곱의 합입니다.
동일한 클러스터의 데이터 포인트 리스트를 받아 해당 클러스터의 WCSS를 반환하는 wcss라는 함수를 만드세요. 다음 단계를 따르세요:
중심점(centroid) 찾기 - 중심점은 클러스터 내 모든 포인트의 평균 위치를 나타내는 포인트입니다:
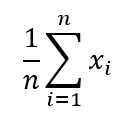
예를 들어, 두 개의 3D 포인트 리스트(1, 2 ,3), (4, 5, 6)가 있다면, 중심점은 다음과 같습니다:(1 + 4) / 2 = 2.5, (2 + 5) / 2 = 3.5, (3 + 6) / 2 = 4.5, >> (2.5, 3.5, 4.5)- 각 포인트와 중심점 사이의 유클리드 거리(Euclidian distance)를 계산합니다.
- 모든 거리의 합을 포인트의 개수로 나눈 값을 반환합니다.
직접 해보기
def euclidian_distance(point_a, point_b):
    return (sum([(point_a[i] - point_b[i])**2 for i in range(len(point_a))]))**0.5

def wcss(points):
# 여기에 코드를 작성하세요머신 러닝 입문의 모든 레슨

직접 연습해 보세요: 온라인 Python 컴파일러