





나이브 베이즈 소개
Coddy의 머신 러닝 입문 코스 레슨. 19개 중 12번째.
나이브 베이즈(Naive Bayes)는 머신러닝에서 분류 작업에 사용되는 단순하면서도 강력한 알고리즘입니다.
나이브 베이즈 알고리즘은 베이즈 정리(Bayes' theorem)를 기반으로 하며, 이는 사건과 관련이 있을 수 있는 조건에 대한 사전 지식을 바탕으로 사건(예: 이메일이 스팸일 확률)의 확률을 계산하는 방법을 알려줍니다. "나이브(naive, 순진한)"라는 부분은 모든 특징(예: 이메일의 단어들)이 서로 독립적이라는 가정에서 유래하며, 이는 계산을 단순화합니다. 독립적이라는 것은 한 가지 일이 일어나는 것이 다른 일이 일어날 확률을 변화시키지 않는다는 것을 의미합니다.
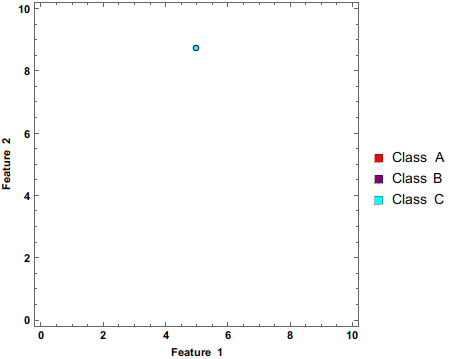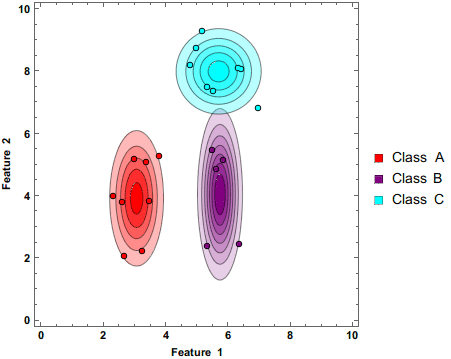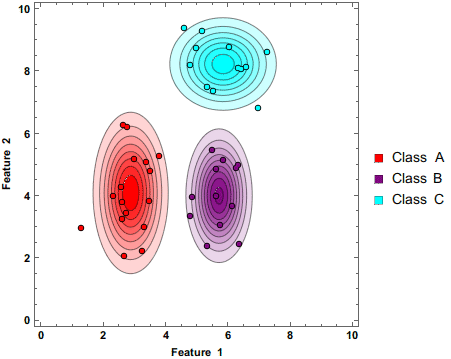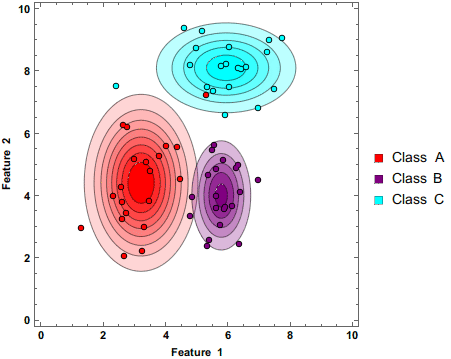
출처: 위키백과, 더 많은 데이터가 입력됨에 따라 추정치를 업데이트하는 나이브 베이즈 분류기.
작동 방식은 다음과 같습니다:
- 빈도수 계산: 먼저, 각 데이터 포인트가 서로 다른 클래스에서 몇 번 나타나는지 계산합니다. 이메일 스팸 탐지에서는 각 단어가 스팸 또는 스팸이 아닌 이메일에 몇 번 나타났는지 계산하고, 의학적 진단에서는 각 증상이 몇 번(또는 얼마나 오래) 나타나는지 계산할 수 있습니다.
- 확률 계산: 새로운 데이터 포인트에 대해 각 클래스에 속할 확률을 계산합니다(새 이메일이 스팸일 확률과 스팸이 아닐 확률은 얼마인지 계산).
- 결정: 마지막으로, 알고리즘은 베이즈 정리를 사용하여 이 모든 확률을 결합하고 이메일이 스팸일 가능성이 높은지 아니면 스팸이 아닐 가능성이 높은지 결정합니다. 확률이 높을수록 해당 클래스에 속할 가능성이 더 큽니다.
나이브 베이즈의 멋진 점은 구현이 빠르고 쉽다는 것입니다. 텍스트와 같은 고차원 데이터에서 잘 작동하며 결측값을 처리할 수 있습니다. 하지만 독립성 가정은 실제 생활에서 항상 사실인 것은 아니며, 이로 인해 더 복잡한 알고리즘에 비해 때때로 덜 정확한 결과를 초래할 수 있습니다.
 실력 점검
이 레슨에는 짧은 퀴즈가 포함되어 있습니다. 레슨을 시작해 문제를 풀고 진행 상황을 기록하세요.
실력 점검이 레슨에는 짧은 퀴즈가 포함되어 있습니다. 레슨을 시작해 문제를 풀고 진행 상황을 기록하세요.
실력 점검이 레슨에는 짧은 퀴즈가 포함되어 있습니다. 레슨을 시작해 문제를 풀고 진행 상황을 기록하세요.

챌린지
중급이 챌린지에서는 특정 클래스에 속할 확률을 계산하는 방법을 배웁니다. 데이터셋 play_outside.csv는 temperature, mood, motivation, windy, play 컬럼을 포함하고 있습니다. 각 행은 동일한 인물을 나타내며, 특징(temperature, mood, motivation, windy)에 따라 그가 밖에서 놀기로 결정했는지 여부를 나타냅니다. 우리의 목표는 특징(temperature, mood, motivation, windy)을 기반으로 그가 밖에서 놀러 나갈지 여부를 예측하는 것입니다.
다음은 데이터셋의 예시입니다:
| temperature | mood | motivation | windy | play |
| low | good | high | no | yes |
| moderate | good | high | no | yes |
| low | low | medium | yes | no |
다음 방정식들이 위협적으로 보일 수 있지만, 하나씩 분석해 보겠습니다.
나이브 베이즈 공식: P(Class|Feature) = P(Feature|Class) * P(Class) / P(Feature)
- P(Feature|Class) - 우도(Likelihood)
- P(Class) - 클래스의 사전 확률(Prior probability)
- P(Feature) - 예측 변수의 사전 확률
- P(Class|Feature) - 즉, 보이지 않는 행이 클래스
<strong>x</strong>로 분류될 확률입니다.
이를 해결하기 위해 공식의 각 구성 요소(P(B|Class) * P(Class) / P(B))를 계산해야 합니다.
- P(Class) - 클래스의 사전 확률
이는 각 클래스의 발생 횟수를 전체 클래스 수로 나눈 값과 같습니다. 예를 들어, 3개 행으로 된 예시에서 yes는2/3이고 no는1/3입니다.P(yes) = 2/3P(no) = 1/3 - P(Feature|Class) - 우도(Likelihood)
이는 주어진 클래스에서 각 특징의 발생 횟수와 같습니다. 예를 들어P(temperature = <strong>low</strong>|play = <strong>yes</strong>)-play = yes인 행이 두 개 있고, (그중play = yes인 행에서만)temperature = low인 행이 하나 있으므로, 이는1/2과 같습니다. - P(Feature)
이는 각 특징의 발생 횟수를 전체 행 수로 나눈 값과 같습니다. 예를 들어:p(motivation=high) = 2/3인데, 이는 동기 부여가 높은(high motivation) 행이 두 개이고 이를 전체 행 수(3)로 나누었기 때문입니다.
챌린지
두 개의 딕셔너리 probability_features, probability_target과 dataset_name이 주어집니다.
각 특징(컬럼)에 대해 각 속성의 확률을 계산하세요.
예를 들어, probability_target의 값은 다음과 같습니다:
probability_target = {
    "yes": 0.66667, # (2/3)
    "no": 0.33333 # (1/3)
}
다음은 probability_features의 값입니다:
probability_features = {
	"temperature": {
		"low": {
			"yes": 0.5, # (1/2)
			"no": 0.5, # (1/2)
		},
		"moderate": {
			"yes": 1, # (1/1)
			"no": 0, # (0/1)
		}
	}
}
특징 이름과 속성 이름은 고정되어 있지 않다는 점에 유의하세요. 각 데이터셋마다 서로 다른 특징과 이름을 가지고 있습니다.
계산을 더 쉽게 하기 위해 pandas 모듈을 사용하는 것을 권장합니다.
직접 해보기
import pandas as pd
probability_features = {}
probability_target = {}
dataset_path = input()
target_variable = input()
df = pd.read_csv(dataset_path)
# 여기에 코드를 작성하세요


# -------------------- 정렬 및 출력 --------------------
# 이 라인 아래로는 수정하지 마세요
sort_features = {q: {k: v for k, v in sorted(a.items() if a != None else {}, key=lambda item: item[0])} for q, a in sorted(probability_features.items(), key=lambda item: item[0])}
sort_target = {k: v for k, v in sorted(probability_target.items(), key=lambda item: item[0])}
print(sort_features)
print(sort_target)머신 러닝 입문의 모든 레슨


직접 연습해 보세요: 온라인 Python 컴파일러