





Introduction à K-Means
Leçon 9 sur 19 du cours Introduction à l’apprentissage automatique de Coddy.
K-means est l'un des algorithmes de partitionnement de données (clustering) les plus simples et les plus utilisés. Il vise à diviser n observations en k clusters dans lesquels chaque observation appartient au cluster ayant la moyenne (centroïde) la plus proche, servant de prototype au cluster. Disons que vous avez un tas de fruits différents et que vous voulez les trier dans des paniers en fonction de leur type, mais que vous n'avez pas d'étiquettes. K-means vous aide à faire exactement cela, mais avec des points de données au lieu de fruits !
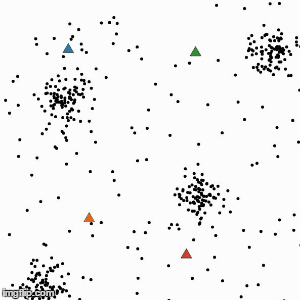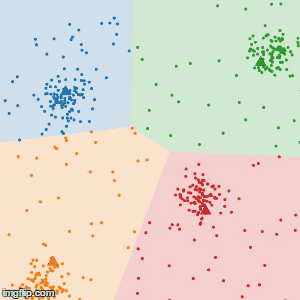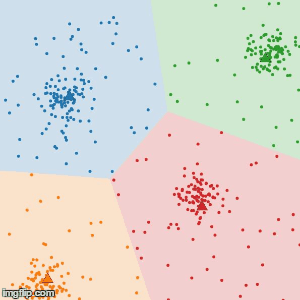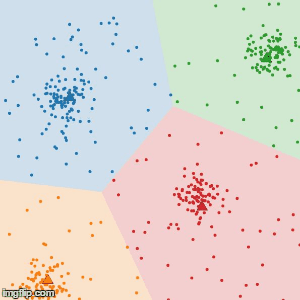
Incheol, CC BY-SA 4.0, via Wikimedia Commons
Comment fonctionne K-Means ?
L'algorithme suit une procédure itérative simple et efficace pour diviser un ensemble de données en k clusters.
- Initialiser les centroïdes : Tout d'abord, choisissez
kpoints comme centroïdes initiaux à partir de l'ensemble de données. Ces points peuvent être sélectionnés au hasard ou sur la base d'une stratégie spécifique. - Assigner les clusters : Pour chaque point de l'ensemble de données, trouvez le centroïde le plus proche (en utilisant des mesures de distance telles que la distance euclidienne) et assignez le point à ce cluster.
- Mettre à jour les centroïdes : Une fois que tous les points sont assignés aux clusters, recalculez les centroïdes en prenant la moyenne de tous les points de chaque cluster.
- Répéter les étapes 2 et 3 : Les étapes ci-dessus sont répétées jusqu'à ce que les centroïdes ne changent plus de manière significative. Cela signifie que l'algorithme a convergé et que les clusters sont stables.
 Testez-vous
Cette leçon comprend un petit quiz. Commencez la leçon pour y répondre et suivre votre progression.
Testez-vousCette leçon comprend un petit quiz. Commencez la leçon pour y répondre et suivre votre progression.
Testez-vousCette leçon comprend un petit quiz. Commencez la leçon pour y répondre et suivre votre progression.

Défi
FacileDéterminer le nombre optimal de clusters, k, est une étape cruciale. Il existe diverses méthodes pour cela, la méthode du coude (Elbow Method) étant l'une des plus populaires.
Cette technique consiste à exécuter les K-means en itérant continuellement de k=1 à k=n. Pour chaque valeur de k, nous calculons la valeur de la somme des carrés au sein des clusters (WCSS - within-cluster sum of squares).
Chaque cluster possède un centroïde, la WCSS est la somme de toutes les distances par rapport au centroïde au carré.
Créez une fonction nommée wcss qui reçoit une liste de points de données (du même cluster) et renvoie la wcss du cluster. Suivez ces étapes :
Trouvez le centroïde - Un centroïde est un point qui représente la position moyenne de tous les points d'un cluster :
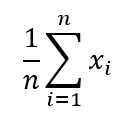
Par exemple, voici une liste de deux points 3D :(1, 2 ,3), (4, 5, 6). Le centroïde est :(1 + 4) / 2 = 2.5, (2 + 5) / 2 = 3.5, (3 + 6) / 2 = 4.5, >> (2.5, 3.5, 4.5)- Calculez la distance euclidienne entre chaque point et le centroïde
- Retournez la somme de toutes les distances divisée par le nombre de points
Essayez vous-même
def euclidian_distance(point_a, point_b):
    return (sum([(point_a[i] - point_b[i])**2 for i in range(len(point_a))]))**0.5

def wcss(points):
# Écrire le code iciToutes les leçons de Introduction à l’apprentissage automatique
1Le début du parcours en ML
Introduction au MLLes données à fournir à un modèleQu’est-ce qu’un modèle de ML ?
Entraînez-vous par vous-même : Compilateur Python en ligne