





Machine à vecteurs de support (SVM)
Leçon 18 sur 19 du cours Introduction à l’apprentissage automatique de Coddy.
La Machine à Vecteurs de Support (SVM) est un algorithme d'apprentissage automatique supervisé puissant et polyvalent utilisé pour les tâches de classification et de régression. Cependant, il est plus couramment utilisé dans les problèmes de classification. Les SVM offrent une grande précision et fonctionnent bien avec un espace de caractéristiques de grande dimension, ce qui les rend adaptés à des applications allant de la reconnaissance d'images à la bio-informatique.
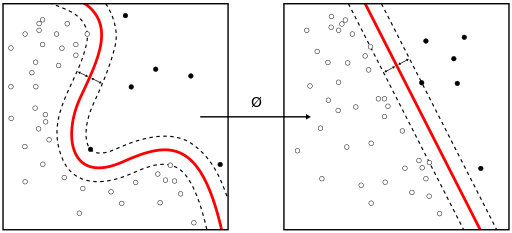
Source : wikipedia
L'objectif principal de l'algorithme SVM est de trouver l'hyperplan optimal (dans un espace bidimensionnel, il s'agit d'une ligne) qui sépare le mieux les classes dans l'espace des caractéristiques. Le modèle SVM représente les exemples comme des points dans l'espace, cartographiés de telle sorte que les exemples de catégories distinctes soient divisés par un écart clair aussi large que possible.
- Hyperplan : Il s'agit essentiellement d'une frontière de décision qui sépare les classes. En 2D, cet hyperplan est une ligne, mais dans des dimensions supérieures, il peut être plus complexe.
- Vecteurs de Support : Ce sont les points de données les plus proches de l'hyperplan, qui sont essentiels pour définir la position de l'hyperplan. Le classificateur SVM est fortement influencé par ces points, d'où le nom de
Support VectorMachine. - Marge : C'est l'écart entre deux lignes sur les points de données les plus proches de différentes classes. Elle peut être considérée comme une mesure de séparation entre les classes. Veiller à ce que la marge soit la plus large possible est un objectif clé de l'entraînement d'un SVM.
Types de SVM :
- SVM Linéaire : Lorsque les données sont linéairement séparables, nous pouvons utiliser une seule ligne droite pour séparer les classes. Ce scénario utilise le SVM linéaire.
- SVM Non-linéaire : Lorsque les données ne sont pas linéairement séparables, le SVM utilise ce qu'on appelle l'astuce du noyau (kernel trick) pour transformer l'espace d'entrée en un espace de dimension supérieure où un hyperplan peut être utilisé pour effectuer la séparation. L'astuce du noyau consiste à transformer les données dans une autre dimension qui présente une marge claire entre les classes de données. Cela permet au SVM de résoudre des problèmes non linéaires. Les noyaux courants incluent :
- Noyau Linéaire : Utilisé lorsque les données sont linéairement séparables.
- Noyau Polynomial : Transforme l'espace de caractéristiques d'origine en un espace de caractéristiques polynomial d'un degré spécifié.
- Noyau Gaussien : Utile pour les données non linéaires qui se regroupent en grappes. Il projette l'espace des caractéristiques dans des dimensions supérieures.
 Testez-vous
Cette leçon comprend un petit quiz. Commencez la leçon pour y répondre et suivre votre progression.
Testez-vousCette leçon comprend un petit quiz. Commencez la leçon pour y répondre et suivre votre progression.
Testez-vousCette leçon comprend un petit quiz. Commencez la leçon pour y répondre et suivre votre progression.

Défi
FacileLes machines à vecteurs de support (SVM) utilisent des fonctions noyau pour transformer les données dans un espace de dimension supérieure où il est plus facile de les classifier. Ce processus est connu sous le nom d' "astuce du noyau" (kernel trick). Il permet aux SVM de résoudre efficacement des problèmes de classification et de régression non linéaires.
Ici, nous allons explorer le noyau polynomial permettant des frontières courbes dans les données. Il élève les données à un degré spécifié d. Ce noyau est particulièrement utile lorsque la relation entre les étiquettes de classe et les attributs est polynomiale.
Source : wikipedia
Créez une fonction nommée polynomial_kernel qui reçoit deux listes (x, y), un degré (d), et un coefficient (c) et retourne le noyau polynomial.

x par y plus c ) à la puissance d.
Essayez vous-même
import numpy as np
def polynomial_kernel(x, y, d, c):
    x_arr = np.array(x)
    y_arr = np.array(y)
# Écrivez votre code iciToutes les leçons de Introduction à l’apprentissage automatique
1Le début du parcours en ML
Introduction au MLLes données à fournir à un modèleQu’est-ce qu’un modèle de ML ?


6Autres modèles
Régression logistiqueRégression linéaireArbre de décisionMachine à vecteurs de support (SVM)Quiz sur les modèlesEntraînez-vous par vous-même : Compilateur Python en ligne