





Einführung in K-Means
Lektion 9 von 19 im Kurs Einführung in maschinelles Lernen von Coddy.
K-Means ist einer der einfachsten und am weitesten verbreiteten Clustering-Algorithmen. Er zielt darauf ab, n Beobachtungen in k Cluster zu unterteilen, wobei jede Beobachtung dem Cluster mit dem nächstgelegenen Mittelwert (Zentroid) angehört, der als Prototyp des Clusters dient. Nehmen wir an, Sie haben einen Haufen verschiedener Früchte und möchten diese nach ihrer Sorte in Körbe sortieren, haben aber keine Etiketten. K-Means hilft Ihnen genau dabei, aber mit Datenpunkten anstelle von Früchten!
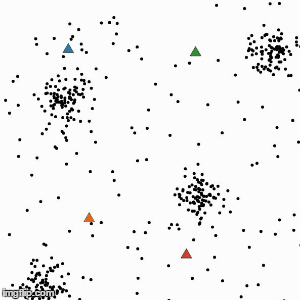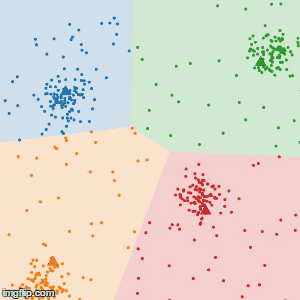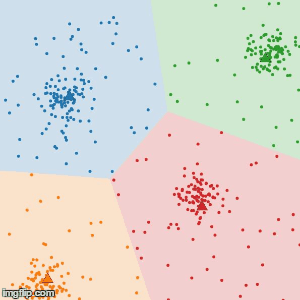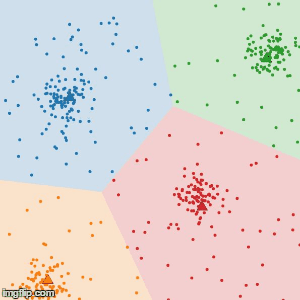
Incheol, CC BY-SA 4.0, via Wikimedia Commons
Wie funktioniert K-Means?
Der Algorithmus folgt einem einfachen und effizienten iterativen Verfahren, um einen Datensatz in k Cluster zu unterteilen.
- Zentroide initialisieren: Wählen Sie zunächst
kPunkte als initiale Zentroide aus dem Datensatz aus. Diese Punkte können zufällig oder basierend auf einer bestimmten Strategie ausgewählt werden. - Cluster zuweisen: Finden Sie für jeden Punkt im Datensatz den nächstgelegenen Zentroiden (unter Verwendung von Abstandsmaßen wie der euklidischen Distanz) und weisen Sie den Punkt diesem Cluster zu.
- Zentroide aktualisieren: Sobald alle Punkte den Clustern zugewiesen sind, berechnen Sie die Zentroide neu, indem Sie den Mittelwert aller Punkte in jedem Cluster bilden.
- Schritte 2 und 3 wiederholen: Die obigen Schritte werden wiederholt, bis sich die Zentroide nicht mehr signifikant verändern. Dies bedeutet, dass der Algorithmus konvergiert ist und die Cluster stabil sind.
 Teste dich selbst
Diese Lektion enthält ein kurzes Quiz. Starte die Lektion, um es zu beantworten und deinen Fortschritt zu speichern.
Teste dich selbstDiese Lektion enthält ein kurzes Quiz. Starte die Lektion, um es zu beantworten und deinen Fortschritt zu speichern.
Teste dich selbstDiese Lektion enthält ein kurzes Quiz. Starte die Lektion, um es zu beantworten und deinen Fortschritt zu speichern.

Aufgabe
EinfachDie Bestimmung der optimalen Anzahl von Clustern, k, ist ein entscheidender Schritt. Es gibt verschiedene Methoden dafür, wobei die Ellenbogen-Methode (Elbow Method) eine der beliebtesten ist.
Diese Technik beinhaltet das kontinuierliche Ausführen von K-Means-Iterationen für k=1 bis k=n. Für jeden Wert von k berechnen wir die Summe der Quadrate innerhalb der Cluster (Within-Cluster Sum of Squares, WCSS).
Jeder Cluster hat einen Zentroiden; die WCSS ist die Summe aller quadrierten Abstände vom Zentroiden.
Erstellen Sie eine Funktion namens wcss, die eine Liste von Datenpunkten (desselben Clusters) erhält und die WCSS des Clusters zurückgibt. Befolgen Sie diese Schritte:
Finden Sie den Zentroiden - Ein Zentroid ist ein Punkt, der die durchschnittliche Position aller Punkte in einem Cluster darstellt:
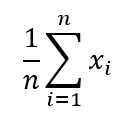
Hier ist zum Beispiel eine Liste von zwei 3D-Punkten:(1, 2 ,3), (4, 5, 6). Der Zentroid ist:(1 + 4) / 2 = 2.5, (2 + 5) / 2 = 3.5, (3 + 6) / 2 = 4.5, >> (2.5, 3.5, 4.5)- Berechnen Sie die euklidische Distanz zwischen jedem Punkt und dem Zentroiden
- Geben Sie die Summe aller Distanzen geteilt durch die Anzahl der Punkte zurück
Probier es selbst
def euclidian_distance(point_a, point_b):
    return (sum([(point_a[i] - point_b[i])**2 for i in range(len(point_a))]))**0.5

def wcss(points):
# Hier Code schreibenAlle Lektionen in Einführung in maschinelles Lernen

Übe selbstständig: Online-Python-Compiler