





Einführung in Naive Bayes
Lektion 12 von 19 im Kurs Einführung in maschinelles Lernen von Coddy.
Naive Bayes ist ein einfacher, aber leistungsstarker Algorithmus, der für Klassifizierungsaufgaben im maschinellen Lernen verwendet wird.
Der Naive-Bayes-Algorithmus basiert auf dem Bayes-Theorem, das uns zeigt, wie man die Wahrscheinlichkeit eines Ereignisses (wie z. B. einer E-Mail, die Spam ist) basierend auf Vorwissen über Bedingungen berechnet, die mit dem Ereignis zusammenhängen könnten. Der „naive“ Teil rührt von der Annahme her, dass alle Merkmale (wie die Wörter in der E-Mail) voneinander unabhängig sind, was die Berechnungen vereinfacht. Unabhängig zu sein bedeutet, dass das Eintreten einer Sache die Chancen für das Eintreten einer anderen Sache nicht verändert.
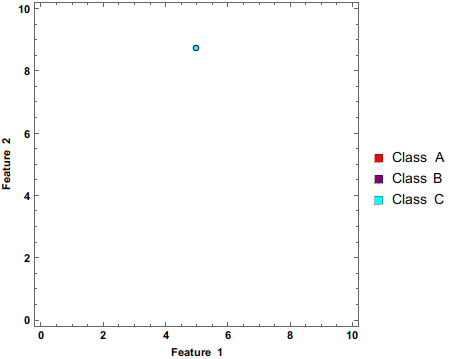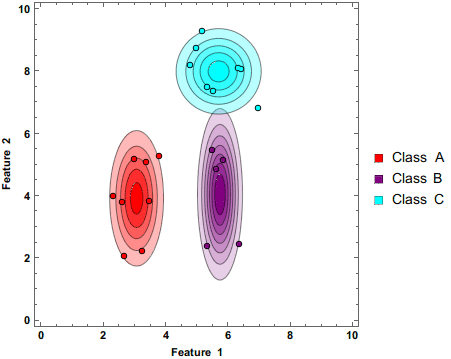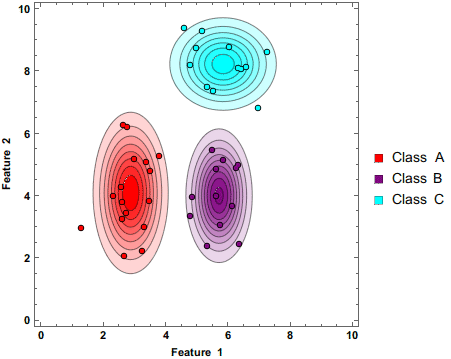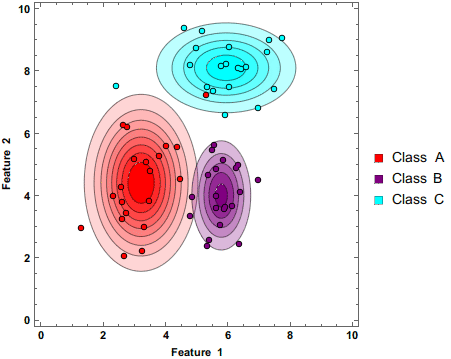
Quelle: Wikipedia, ein Naive-Bayes-Klassifikator, der seine Schätzung aktualisiert, während ihm mehr Daten zugeführt werden.
So funktioniert es:
- Vorkommen zählen: Zuerst wird gezählt, wie oft jeder Datenpunkt in verschiedenen Klassen vorkommt. Bei der E-Mail-Spam-Erkennung zählen wir, wie oft jedes Wort in Spam- oder Nicht-Spam-E-Mails vorkam; bei der medizinischen Diagnose könnten wir zählen, wie oft (oder wie lange) jedes Symptom auftritt.
- Wahrscheinlichkeiten berechnen: Berechnen Sie für einen neuen Datenpunkt die Wahrscheinlichkeit der Zugehörigkeit zu jeder Klasse (wie hoch ist die Wahrscheinlichkeit, dass eine neue E-Mail Spam ist, und wie hoch ist die Wahrscheinlichkeit, dass sie kein Spam ist)
- Entscheidung: Schließlich kombiniert der Algorithmus all diese Wahrscheinlichkeiten mithilfe des Bayes-Theorems und entscheidet, ob die E-Mail eher Spam oder kein Spam ist. Je höher die Wahrscheinlichkeit, desto wahrscheinlicher gehört sie zu dieser Klasse.
Das Tolle an Naive Bayes ist seine schnelle und einfache Implementierung. Es funktioniert gut mit hochdimensionalen Daten (wie Text) und kann mit fehlenden Werten umgehen. Die Unabhängigkeitsannahme trifft jedoch im wirklichen Leben nicht immer zu, was manchmal zu weniger genauen Ergebnissen im Vergleich zu komplexeren Algorithmen führen kann.
 Teste dich selbst
Diese Lektion enthält ein kurzes Quiz. Starte die Lektion, um es zu beantworten und deinen Fortschritt zu speichern.
Teste dich selbstDiese Lektion enthält ein kurzes Quiz. Starte die Lektion, um es zu beantworten und deinen Fortschritt zu speichern.
Teste dich selbstDiese Lektion enthält ein kurzes Quiz. Starte die Lektion, um es zu beantworten und deinen Fortschritt zu speichern.

Aufgabe
MittelIn dieser Herausforderung lernen wir, wie man die Wahrscheinlichkeit berechnet, einer bestimmten Klasse anzugehören. Der Datensatz play_outside.csv enthält die folgenden Spalten: temperature, mood, motivation, windy, play. Jede Zeile repräsentiert dieselbe Person und die Entscheidung, ob sie basierend auf den Merkmalen (temperature, mood, motivation, windy) draußen spielen gegangen ist oder nicht. Unser Ziel ist es vorherzusagen, ob die Person basierend auf den Merkmalen (temperature, mood, motivation, windy) draußen spielen wird.
Hier ist ein Beispiel für einen Datensatz:
| temperature | mood | motivation | windy | play |
| low | good | high | no | yes |
| moderate | good | high | no | yes |
| low | low | medium | yes | no |
Die folgenden Gleichungen mögen einschüchternd wirken, aber wir werden sie aufschlüsseln.
Naive Bayes Formel: P(Class|Feature) = P(Feature|Class) * P(Class) / P(Feature)
- P(Feature|Class) - Likelihood (Wahrscheinlichkeit der Merkmale gegeben die Klasse)
- P(Class) - Prior probability of the class (A-priori-Wahrscheinlichkeit der Klasse)
- P(Feature) - Prior probability of the predictor (A-priori-Wahrscheinlichkeit des Prädiktors)
- P(Class|Feature) - Mit anderen Worten: Wie hoch ist die Wahrscheinlichkeit, dass die unbekannte Zeile der Klasse
<strong>x</strong>zugeordnet wird.
Um dies zu lösen, müssen wir jede der Komponenten der Formel berechnen (P(B|Class) * P(Class) / P(B))
- P(Class) - Prior probability of class
Dies entspricht der Anzahl der Vorkommen jeder Klasse, geteilt durch die Gesamtzahl der Klassen. In unserem 3-Zeilen-Beispiel gibt es zum Beispiel2/3yes und1/3no.P(yes) = 2/3P(no) = 1/3 - P(Feature|Class) - Likelihood
Dies entspricht der Anzahl der Vorkommen jedes Merkmals einer gegebenen Klasse. Zum Beispiel:P(temperature = <strong>low</strong>|play = <strong>yes</strong>)- Es gibt zwei Zeilen, in denenplay = yesist, und eine Zeile, in dertemperature = lowist (nur von den Zeilen, in denenplay = yesist), also entspricht dies1/2. - P(Feature)
Dies entspricht der Anzahl der Vorkommen jedes Merkmals geteilt durch die Gesamtzahl der Zeilen. Zum Beispiel:p(motivation=high) = 2/3, da es zwei Zeilen mit hoher Motivation gibt, geteilt durch die Gesamtzahl der Zeilen (3).
Die Herausforderung
Gegeben sind zwei Dictionaries probability_features, probability_target und der dataset_name.
Berechnen Sie für jedes Merkmal (Spalte) die Wahrscheinlichkeit jedes Attributs.
Hier ist zum Beispiel der Wert von probability_target:
probability_target = {
    "yes": 0.66667, # (2/3)
    "no": 0.33333 # (1/3)
}
Hier ist der Wert von probability_features:
probability_features = {
	"temperature": {
		"low": {
			"yes": 0.5, # (1/2)
			"no": 0.5, # (1/2)
		},
		"moderate": {
			"yes": 1, # (1/1)
			"no": 0, # (0/1)
		}
	}
}
Beachten Sie, dass die Merkmalsnamen (feature names) und die Attributnamen nicht konstant sind. Jeder Datensatz hat unterschiedliche Merkmale und unterschiedliche Namen.
Ich empfehle die Verwendung des pandas-Moduls, um die Berechnungen zu erleichtern.
Probier es selbst
import pandas as pd
probability_features = {}
probability_target = {}
dataset_path = input()
target_variable = input()
df = pd.read_csv(dataset_path)
# Schreibe deinen Code hier


# -------------------- Sortieren und ausgeben --------------------
# Unterhalb dieser Zeile nichts ändern
sort_features = {q: {k: v for k, v in sorted(a.items() if a != None else {}, key=lambda item: item[0])} for q, a in sorted(probability_features.items(), key=lambda item: item[0])}
sort_target = {k: v for k, v in sorted(probability_target.items(), key=lambda item: item[0])}
print(sort_features)
print(sort_target)Alle Lektionen in Einführung in maschinelles Lernen


Übe selbstständig: Online-Python-Compiler