





Support Vector Machine (SVM)
Lektion 18 von 19 im Kurs Einführung in maschinelles Lernen von Coddy.
Support Vector Machine (SVM) ist ein leistungsstarker und vielseitiger überwachter Machine-Learning-Algorithmus, der sowohl für Klassifizierungs- als auch für Regressionsaufgaben verwendet wird. Er wird jedoch häufiger bei Klassifizierungsproblemen eingesetzt. SVMs bieten eine hohe Genauigkeit und schneiden bei einem hochdimensionalen Merkmalsraum gut ab, wodurch sie für Anwendungen von der Bilderkennung bis zur Bioinformatik geeignet sind.
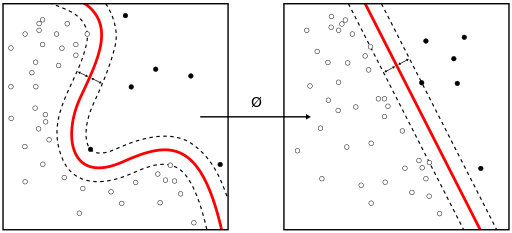
Quelle: wikipedia
Das Hauptziel des SVM-Algorithmus besteht darin, die optimale Hyperebene (im zweidimensionalen Raum ist dies eine Linie) zu finden, welche die Klassen im Merkmalsraum am besten trennt. Das SVM-Modell stellt die Beispiele als Punkte im Raum dar, die so abgebildet werden, dass die Beispiele der einzelnen Kategorien durch eine klare Lücke getrennt sind, die so breit wie möglich ist.
- Hyperebene: Dies ist im Grunde eine Entscheidungsgrenze, welche die Klassen trennt. In 2D ist diese Hyperebene eine Linie, aber in höheren Dimensionen kann sie komplexer sein.
- Support-Vektoren: Dies sind die Datenpunkte, die der Hyperebene am nächsten liegen und entscheidend für die Definition der Position der Hyperebene sind. Der SVM-Klassifikator wird stark von diesen Punkten beeinflusst, daher der Name
Support VectorMachine. - Margin (Rand): Es ist der Abstand zwischen zwei Linien an den nächstgelegenen Datenpunkten verschiedener Klassen. Er kann als separates Maß zwischen den Klassen betrachtet werden. Sicherzustellen, dass der Rand so breit wie möglich ist, ist ein Hauptziel beim Training einer SVM.
Arten von SVM:
- Lineare SVM: Wenn die Daten linear trennbar sind, können wir eine einzelne gerade Linie verwenden, um die Klassen zu trennen. Dieses Szenario verwendet die lineare SVM.
- Nicht-lineare SVM: Wenn die Daten nicht linear trennbar sind, verwendet die SVM den sogenannten Kernel-Trick, um den Eingaberaum in einen höherdimensionalen Raum zu transformieren, in dem eine Hyperebene zur Trennung verwendet werden kann. Der Kernel-Trick beinhaltet die Transformation der Daten in eine andere Dimension, die einen klaren Rand zwischen den Datenklassen aufweist. Er ermöglicht es der SVM, nicht-lineare Probleme zu lösen. Gängige Kernel sind:
- Linearer Kernel: Wird verwendet, wenn die Daten linear trennbar sind.
- Polynomialer Kernel: Transformiert den ursprünglichen Merkmalsraum in einen polynomialen Merkmalsraum eines bestimmten Grades.
- Gauß-Kernel: Nützlich für nicht-lineare Daten, die sich in Gruppen zusammenfinden. Er bildet den Merkmalsraum in höhere Dimensionen ab.
 Teste dich selbst
Diese Lektion enthält ein kurzes Quiz. Starte die Lektion, um es zu beantworten und deinen Fortschritt zu speichern.
Teste dich selbstDiese Lektion enthält ein kurzes Quiz. Starte die Lektion, um es zu beantworten und deinen Fortschritt zu speichern.
Teste dich selbstDiese Lektion enthält ein kurzes Quiz. Starte die Lektion, um es zu beantworten und deinen Fortschritt zu speichern.

Aufgabe
EinfachSupport Vector Machines (SVMs) verwenden Kernelfunktionen, um Daten in einen höherdimensionalen Raum zu transformieren, in dem sie einfacher zu klassifizieren sind. Dieser Prozess ist als "Kernel-Trick" bekannt. Er ermöglicht es SVMs, nicht-lineare Klassifikations- und Regressionsprobleme effizient zu lösen.
Hier werden wir den polynomialen Kernel untersuchen, der gekrümmte Grenzen in den Daten ermöglicht. Er hebt die Daten auf einen spezifizierten Grad d an. Dieser Kernel ist besonders nützlich, wenn die Beziehung zwischen den Klassenbezeichnungen und den Attributen polynomial ist.
Quelle: wikipedia
Erstellen Sie eine Funktion namens polynomial_kernel, die zwei Listen (x, y), einen Grad (d) und einen Koeffizienten (c) erhält und den polynomialen Kernel zurückgibt.

x transponiert Skalarprodukt y plus c ) hoch d.
Probier es selbst
import numpy as np
def polynomial_kernel(x, y, d, c):
    x_arr = np.array(x)
    y_arr = np.array(y)
# Schreiben Sie hier Ihren CodeAlle Lektionen in Einführung in maschinelles Lernen


6Weitere Modelle
Logistische RegressionLineare RegressionEntscheidungsbaumSupport Vector Machine (SVM)Quiz zu ModellenÜbe selbstständig: Online-Python-Compiler