





Einführung in KNN
Lektion 6 von 19 im Kurs Einführung in maschinelles Lernen von Coddy.
K-Nearest Neighbors (KNN) ist ein überwachter Lernalgorithmus, der sowohl für Klassifizierungs- als auch für Regressionsprobleme verwendet wird. Er ist einfach und dennoch leistungsstark und wird oft als Ausgangspunkt (Baseline) für komplexere Modelle verwendet.
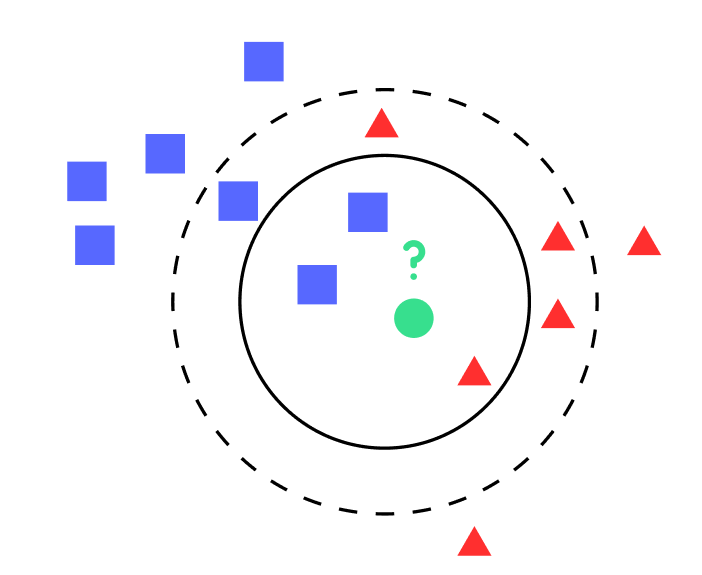
Der KNN-Algorithmus findet Merkmalsähnlichkeiten mithilfe von Distanzmetriken, um die nächsten Nachbarn eines Punktes zu identifizieren. Zum Beispiel kann er Weine sortieren, indem er sie mit den nächstgelegenen vergleicht, etwa indem er Weine mit ähnlichen Geschmacksrichtungen gruppiert. Es ist, als hätte man einen Führer, der einem hilft herauszufinden, welche Weine sich aufgrund ihrer häufigsten Merkmale ähneln. 🍷
Die Idee hinter KNN ist recht einfach:
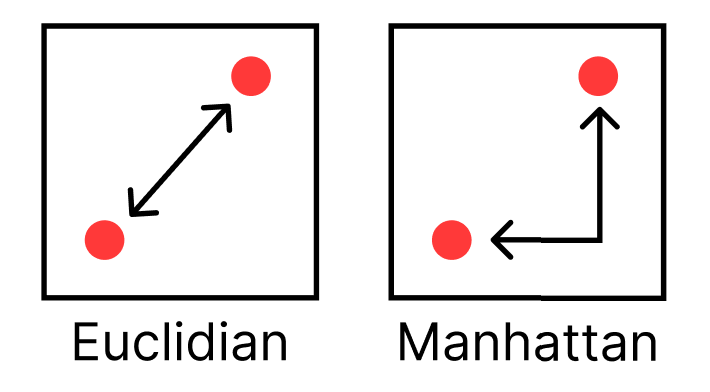
- Distanzberechnung: Für einen gegebenen Testpunkt berechnet der Algorithmus die Distanz zwischen diesem Punkt und jedem anderen Punkt im Trainingsdatensatz. Die Distanz kann auf verschiedene Arten berechnet werden, z. B. als euklidische oder Manhattan-Distanz.
- Nächste Nachbarn finden: Der Algorithmus wählt dann die
kPunkte in den Trainingsdaten aus, die dem Testpunkt am nächsten liegen.kist eine benutzerdefinierte Konstante und kann eine beliebige Ganzzahl sein. - Vorhersage treffen: Bei der Klassifizierung weist der Algorithmus dem Testpunkt das am häufigsten vorkommende Klassenlabel unter den
knächsten Nachbarn zu. Bei der Regression weist er den Durchschnitt der „k“ nächsten Nachbarn zu.
KNN ist ein „Lazy Learning“-Algorithmus, was bedeutet, dass er eigentlich kein Modell lernt. Stattdessen speichert er die Trainingsinstanzen und verwendet sie für die Vorhersage (die nächste Lektion wird die Trainingsphase behandeln). Dies macht KNN während der Testphase rechenintensiv.
Trotz seiner Einfachheit kann KNN eine überraschend gute Leistung erzielen. Es reagiert jedoch empfindlich auf die Wahl von k und die Art der Distanzmetrik und schneidet bei hochdimensionalen Daten aufgrund des Fluchs der Dimensionalität nicht gut ab.
 Teste dich selbst
Diese Lektion enthält ein kurzes Quiz. Starte die Lektion, um es zu beantworten und deinen Fortschritt zu speichern.
Teste dich selbstDiese Lektion enthält ein kurzes Quiz. Starte die Lektion, um es zu beantworten und deinen Fortschritt zu speichern.
Teste dich selbstDiese Lektion enthält ein kurzes Quiz. Starte die Lektion, um es zu beantworten und deinen Fortschritt zu speichern.

Aufgabe
EinfachIn dieser Herausforderung werden wir verschiedene Distanzberechnungen kennenlernen.
Erstellen Sie eine Funktion namens distances_option_calculator, die drei Variablen erhält: X, y und distance_type. Die Funktion gibt die Distanz zwischen X und y entsprechend dem distance_type zurück.
Hier ist eine Liste gängiger Distanzberechnungen:
Euclidian Distanz (am gebräuchlichsten): Die geradlinige Distanz zwischen zwei Punkten. Die Quadratwurzel aus der Summe der Quadrate der Differenzen zwischen den jeweils entsprechenden Koordinaten der Punkte:
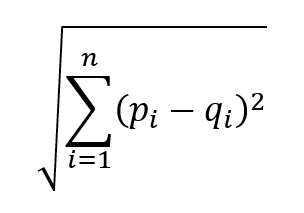
Manhattan Distanz ist auch als Taxicab- oder City-Block-Distanz bekannt. Die Summe der absoluten Differenzen zwischen den Punkten über alle Dimensionen hinweg. Für zwei Punkte ( P ) und ( Q ) mit den Koordinaten ( (p_1, p_2, …, p_n) ) bzw. ( (q_1, q_2, …, q_n) ):
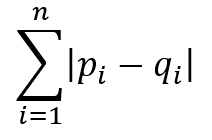
Hamming Distanz: Die Anzahl der Positionen, an denen die entsprechenden Symbole unterschiedlich sind. Sie wird häufig für kategoriale Daten verwendet.
Nehmen wir zum Beispiel zwei Binärstrings:
String 1: 1101
String 2: 1001
Beim positionsweisen Vergleich sehen wir, dass die zweite Position unterschiedliche Bits hat (1 in String 1 und 0 in String 2). Alle anderen Positionen sind gleich. Die Hamming-Distanz zwischen diesen beiden Strings beträgt also 1.
Der distance_type kann die folgenden Werte annehmen: "hamming", "manhattan", "euclidian".
Probier es selbst
def distances_option_calculator(X, y, distance_type):
    # Hier Code schreiben
    if distance_type == "euclidian":
        pass
    elif distance_type == "manhattan":
        pass
    elif distance_type == "hamming":
passAlle Lektionen in Einführung in maschinelles Lernen

Übe selbstständig: Online-Python-Compiler