





K-Meansの概要
Coddyの「機械学習入門」コースのレッスン 9/19。
K-meansは、最もシンプルで広く使用されているクラスタリングアルゴリズムの1つです。これは、n個の観測値をk個のクラスターに分割することを目的としており、各観測値は、クラスターのプロトタイプとして機能する最も近い平均(セントロイド)を持つクラスターに属します。例えば、たくさんの種類の果物があり、それらをラベルなしで種類ごとにバスケットに分けたいとします。K-meansは、果物の代わりにデータポイントを使って、まさにそれを実現するのに役立ちます!
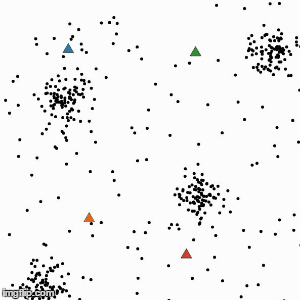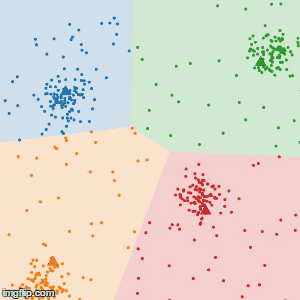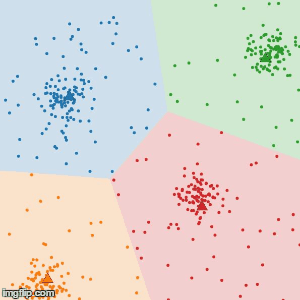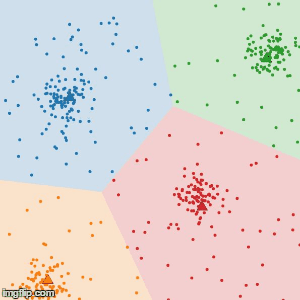
Incheol, CC BY-SA 4.0, Wikimedia Commons経由
K-Meansはどのように機能しますか?
このアルゴリズムは、データセットをk個のクラスターに分割するために、シンプルで効率的な反復手順に従います。
- セントロイドの初期化:まず、データセットから初期セントロイドとして
k個の点を選択します。これらの点は、ランダムに選択することも、特定の戦略に基づいて選択することもできます。 - クラスターの割り当て:データセット内の各点について、最も近いセントロイド(ユークリッド距離などの距離尺度を使用)を見つけ、その点をそのクラスターに割り当てます。
- セントロイドの更新:すべての点がクラスターに割り当てられたら、各クラスター内のすべての点の平均をとってセントロイドを再計算します。
- ステップ2と3の繰り返し:セントロイドが大きく変化しなくなるまで、上記のステップを繰り返します。これはアルゴリズムが収束し、クラスターが安定したことを意味します。
 腕試し
このレッスンには短いクイズがあります。レッスンを始めて解答し、進捗を記録しましょう。
腕試しこのレッスンには短いクイズがあります。レッスンを始めて解答し、進捗を記録しましょう。
腕試しこのレッスンには短いクイズがあります。レッスンを始めて解答し、進捗を記録しましょう。

チャレンジ
簡単最適なクラスター数 k を決定することは、非常に重要なステップです。これにはさまざまな方法がありますが、エルボー法(Elbow Method)が最も一般的な手法の一つです。
この手法では、k=1 から k=n まで K-means を繰り返し実行します。それぞれの k の値に対して、クラスター内誤差平方和(WCSS)の値を計算します。
各クラスターにはセントロイド(重心)があり、WCSS はセントロイドからのすべての距離の 2 乗の合計です。
(同じクラスターの)データポイントのリストを受け取り、そのクラスターの WCSS を返す wcss という名前の関数を作成してください。以下の手順に従ってください:
セントロイドを見つける - セントロイドは、クラスター内のすべてのポイントの平均位置を表すポイントです:
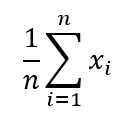
例えば、2つの3Dポイントのリスト(1, 2 ,3), (4, 5, 6)がある場合、セントロイドは以下のようになります:(1 + 4) / 2 = 2.5, (2 + 5) / 2 = 3.5, (3 + 6) / 2 = 4.5, >> (2.5, 3.5, 4.5)- 各ポイントからセントロイドまでのユークリッド距離を計算する
- すべての距離の合計をポイントの数で割った値を返す
自分で試してみよう
def euclidian_distance(point_a, point_b):
    return (sum([(point_a[i] - point_b[i])**2 for i in range(len(point_a))]))**0.5

def wcss(points):
# ここにコードを記述してください機械学習入門のすべてのレッスン

自分で練習してみよう: Pythonオンラインコンパイラ