





KNNの概要
Coddyの「機械学習入門」コースのレッスン 6/19。
K近傍法(KNN)は、分類と回帰の両方の問題に使用される教師あり学習アルゴリズムです。シンプルでありながら強力で、より複雑なモデルのベースラインとしてよく使用されます。
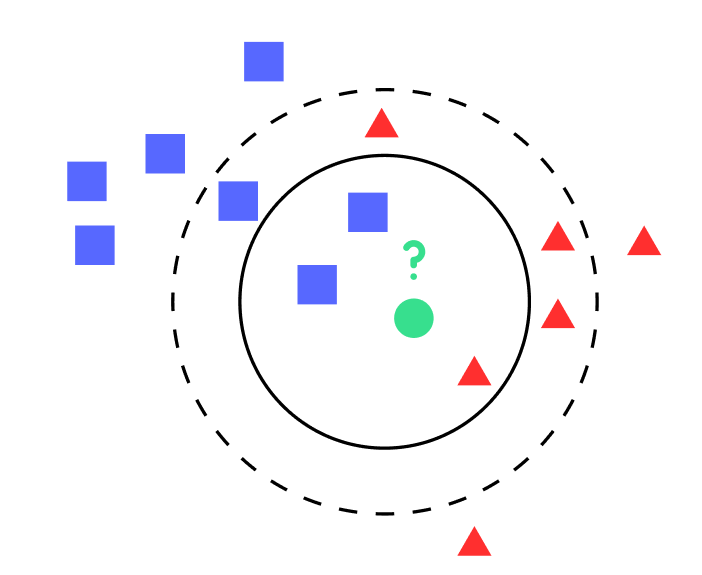
KNNアルゴリズムは、距離指標を使用して特徴の類似性を見つけ、ある点に最も近い近傍を特定します。例えば、似たような風味のワインをグループ化するように、最も近いものと比較することでワインを分類できます。これは、最も一般的な特徴に基づいて、どのワインが似ているかを見つけるのを助けてくれるガイドがいるようなものです。 🍷
KNNの背後にある考え方は非常に単純です:
- 距離の計算:特定のテストポイントに対して、アルゴリズムはそのポイントとトレーニングデータセット内の他のすべてのポイントとの間の距離を計算します。距離は、ユークリッド距離やマンハッタン距離など、さまざまな方法で計算できます。
- 最近傍を見つける:次に、アルゴリズムはトレーニングデータの中でテストポイントに最も近い
k個のポイントを選択します。kはユーザー定義の定数であり、任意の整数にすることができます。 - 予測を行う:分類の場合、アルゴリズムはテストポイントに対して
k個の最近傍の中で最も一般的なクラスラベルを割り当てます。回帰の場合、k個の最近傍の平均を割り当てます。
KNNは怠惰学習(lazy learning)アルゴリズムであり、実際にはモデルを学習しないことを意味します。代わりに、トレーニングインスタンスを記憶し、それらを予測に使用します(次のレッスンでトレーニングフェーズについて説明します)。これにより、KNNはテストフェーズ中に計算コストが高くなります。
そのシンプルさにもかかわらず、KNNは驚くほど優れたパフォーマンスを達成できます。しかし、k の選択や距離指標の種類に敏感であり、次元の呪いのため、高次元データではうまく機能しません。
 腕試し
このレッスンには短いクイズがあります。レッスンを始めて解答し、進捗を記録しましょう。
腕試しこのレッスンには短いクイズがあります。レッスンを始めて解答し、進捗を記録しましょう。
腕試しこのレッスンには短いクイズがあります。レッスンを始めて解答し、進捗を記録しましょう。

チャレンジ
簡単このチャレンジでは、さまざまな距離計算について学びます。
X、y、および distance_type の3つの変数を受け取る distances_option_calculator という名前の関数を作成してください。この関数は、distance_type に応じて X と y の間の距離を返します。
以下は、一般的な距離計算のリストです:
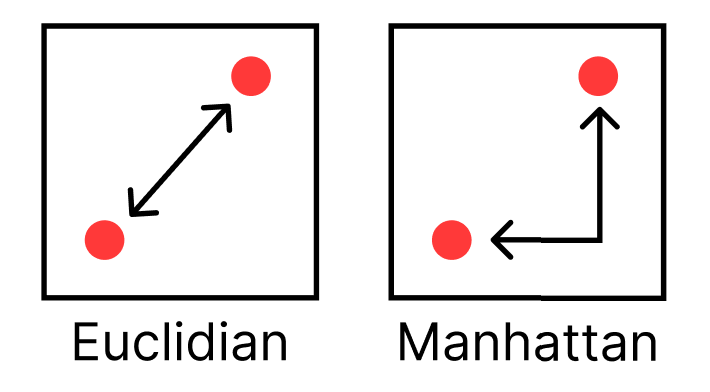
Euclidian(ユークリッド)距離(最も一般的):2点間の直線距離です。各座標の差の2乗の合計の平方根として計算されます:
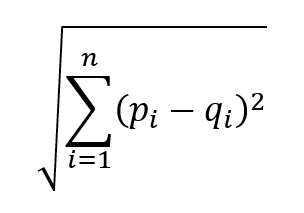
Manhattan(マンハッタン)距離:タクシー距離や市街地距離とも呼ばれます。すべての次元における点間の絶対差の合計です。2つの点 ( P ) と ( Q ) があり、それぞれの座標が ( (p_1, p_2, …, p_n) ) と ( (q_1, q_2, …, q_n) ) である場合:
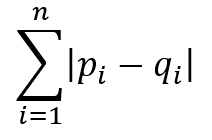
Hamming(ハミング)距離:対応するシンボルが異なる位置の数です。カテゴリデータによく使用されます。
例えば、2つのバイナリ文字列を見てみましょう:
String 1: 1101
String 2: 1001
これらを位置ごとに比較すると、2番目の位置のビットが異なっていることがわかります(String 1 は 1、String 2 は 0)。他のすべての位置は同じです。したがって、これら2つの文字列間のハミング距離は 1 です。
distance_type には、"hamming"、"manhattan"、"euclidian" のいずれかが指定されます。
自分で試してみよう
def distances_option_calculator(X, y, distance_type):
    # ここにコードを記述してください
    if distance_type == "euclidian":
        pass
    elif distance_type == "manhattan":
        pass
    elif distance_type == "hamming":
pass機械学習入門のすべてのレッスン

自分で練習してみよう: Pythonオンラインコンパイラ