





ナイーブベイズ入門
Coddyの「機械学習入門」コースのレッスン 12/19。
ナイーブベイズは、機械学習における分類タスクに使用される、シンプルながらも強力なアルゴリズムです。
ナイーブベイズアルゴリズムはベイズの定理に基づいています。これは、イベントに関連する可能性のある条件の事前知識に基づいて、イベント(メールがスパムであるなど)の確率を計算する方法を教えてくれます。「ナイーブ(素朴)」という部分は、すべての特徴(メール内の単語など)が互いに独立しているという仮定に由来しており、これにより計算が簡素化されます。独立しているということは、あることが起きても別のことが起きる確率が変わらないことを意味します。
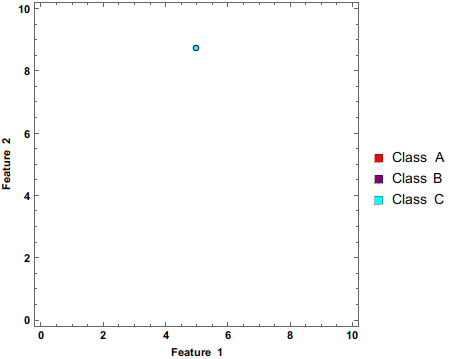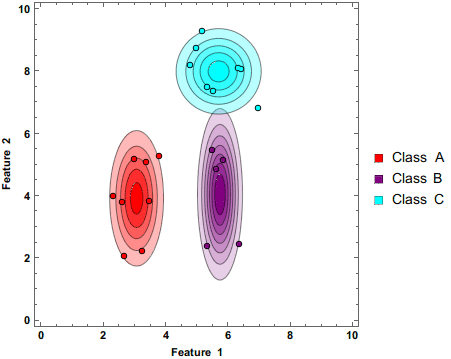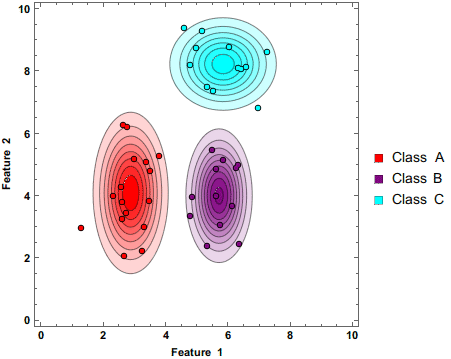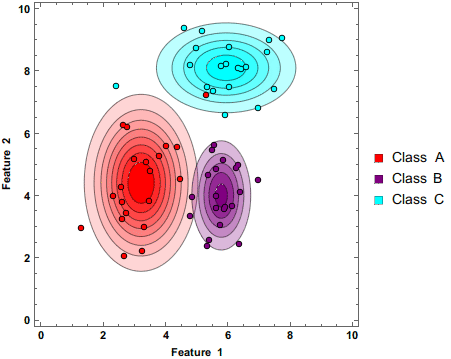
出典: Wikipedia, データが提供されるにつれて推定値を更新するナイーブベイズ分類器。
仕組みは以下の通りです:
- 出現回数のカウント: まず、各データポイントが異なるクラスに何回出現するかをカウントします。メールのスパム検出では、各単語がスパムメールまたは非スパムメールに何回出現したかをカウントします。医療診断では、各症状が何回(またはどのくらいの期間)現れるかをカウントすることがあります。
- 確率の計算: 新しいデータポイントについて、各クラスに属する確率を計算します(新しいメールがスパムである確率と、スパムではない確率はどれくらいか)。
- 決定: 最後に、アルゴリズムはベイズの定理を使用してこれらすべての確率を組み合わせ、メールがスパムである可能性が高いか、そうでないかを判断します。確率が高いほど、そのクラスに属する可能性が高くなります。
ナイーブベイズの素晴らしい点は、実装が高速で簡単なことです。テキストのような高次元データでもうまく機能し、欠損値も処理できます。しかし、独立性の仮定は現実の世界では必ずしも真実ではなく、より複雑なアルゴリズムと比較して結果の精度が低くなることがあります。
 腕試し
このレッスンには短いクイズがあります。レッスンを始めて解答し、進捗を記録しましょう。
腕試しこのレッスンには短いクイズがあります。レッスンを始めて解答し、進捗を記録しましょう。
腕試しこのレッスンには短いクイズがあります。レッスンを始めて解答し、進捗を記録しましょう。

チャレンジ
中級このチャレンジでは、特定のクラスに属する確率を計算する方法を学びます。データセット play_outside.csv には、temperature, mood, motivation, windy, play という列が含まれています。各行は同一人物を表し、特徴量(temperature, mood, motivation, windy)に基づいて、その人が外で遊ぶかどうかを決定した結果を示しています。私たちの目標は、特徴量(temperature, mood, motivation, windy)に基づいて、その人が外で遊ぶかどうかを予測することです。
データセットの例を以下に示します:
| temperature | mood | motivation | windy | play |
| low | good | high | no | yes |
| moderate | good | high | no | yes |
| low | low | medium | yes | no |
次の数式は難しそうに見えるかもしれませんが、分解して説明します。
ナイーブベイズの公式: P(Class|Feature) = P(Feature|Class) * P(Class) / P(Feature)
- P(Feature|Class) - 尤度(Likelihood)
- P(Class) - クラスの事前確率
- P(Feature) - 予測変数の事前確率
- P(Class|Feature) - 言い換えれば、未知の行がクラス
<strong>x</strong>に分類される確率はどれくらいか、ということです。
これを解くには、公式の各構成要素(P(B|Class) * P(Class) / P(B))を計算する必要があります。
- P(Class) - クラスの事前確率
これは、各クラスの出現回数をクラスの総数で割ったものに等しくなります。例えば、3行の例では、2/3が yes で、1/3が no です。P(yes) = 2/3P(no) = 1/3 - P(Feature|Class) - 尤度
これは、特定のクラスにおける各特徴量の出現回数に等しくなります。例えば、P(temperature = <strong>low</strong>|play = <strong>yes</strong>)-play = yesである行は2つあり、そのうちtemperature = lowである行は1つなので、これは1/2になります。 - P(Feature)
これは、各特徴量の出現回数を全行数で割ったものに等しくなります。例えば:p(motivation=high) = 2/3となります。なぜなら、high motivation の行が2つあり、それを全行数(3)で割るからです。
チャレンジ
2つの辞書 probability_features、probability_target と dataset_name が与えられます。
各特徴量(列)について、各属性の確率を計算してください。
例えば、probability_target の値は以下のようになります:
probability_target = {
    "yes": 0.66667, # (2/3)
    "no": 0.33333 # (1/3)
}
probability_features の値は以下のようになります:
probability_features = {
	"temperature": {
		"low": {
			"yes": 0.5, # (1/2)
			"no": 0.5, # (1/2)
		},
		"moderate": {
			"yes": 1, # (1/1)
			"no": 0, # (0/1)
		}
	}
}
特徴量名や属性名は固定ではないことに注意してください。データセットごとに異なる特徴量と異なる名前を持っています。
計算を簡単にするために、pandas モジュールを使用することをお勧めします。
自分で試してみよう
import pandas as pd
probability_features = {}
probability_target = {}
dataset_path = input()
target_variable = input()
df = pd.read_csv(dataset_path)
# ここにコードを書いてください


# -------------------- ソートと出力 --------------------
# この行より下は変更しないでください
sort_features = {q: {k: v for k, v in sorted(a.items() if a != None else {}, key=lambda item: item[0])} for q, a in sorted(probability_features.items(), key=lambda item: item[0])}
sort_target = {k: v for k, v in sorted(probability_target.items(), key=lambda item: item[0])}
print(sort_features)
print(sort_target)機械学習入門のすべてのレッスン


自分で練習してみよう: Pythonオンラインコンパイラ